本地分数突然高得离谱,绝大多数时候不是天才时刻,而是数据泄露:模型在训练时看到了它在真实预测场景下拿不到的信息。学生对此往往毫无警觉——分数在涨,看起来一切顺利,直到最终结算时排名塌下来,或者把一个建立在泄露上的结论写进学校项目。
这篇文章拆解四种最常见的泄露形态、提交前的四步自检,以及它和”过拟合公开榜”到底差在哪。刚接触平台的读者可以先看《Kaggle 是什么?完整入门指南》把基本概念补齐。
一、先把定义说准:什么叫泄露
泄露的定义只有一句:训练时用上了预测时刻拿不到的信息。判断标准不是”这个字段在数据里存不存在”,而是”在我要做预测的那一刻,这个信息已经产生了吗“。
举个非技术的例子:要预测一个学生期末会不会挂科,如果特征里混进了”是否参加了补考”,模型当然准得惊人——但补考发生在期末之后,真实预测的那一刻根本没有这个字段。模型学到的不是规律,而是答案的影子。
泄露之所以危险,在于它的症状是好消息:分数变高、模型看起来更聪明。人对好消息天然缺乏怀疑,所以自检必须是一道固定流程,而不是”感觉不对时才查”。
二、四种最常见的泄露形态
| 形态 | 发生了什么 | 典型症状 | 怎么修 |
|---|---|---|---|
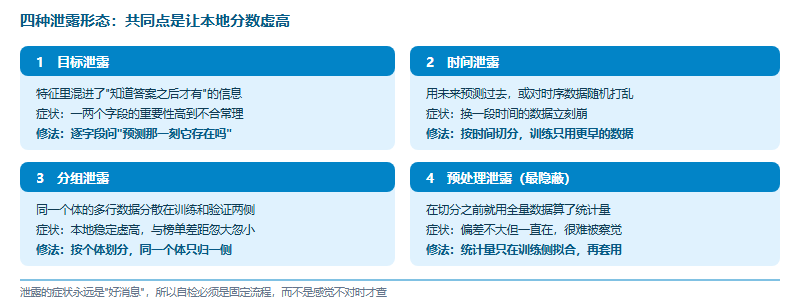
| 目标泄露 | 特征里含有只有知道结果之后才会存在的信息 | 某一两个字段的重要性远超其它所有字段之和 | 逐字段问”预测那一刻它存在吗”,不存在就删掉 |
| 时间泄露 | 用未来的数据训练、去预测过去;或对时间序列随机打乱切分 | 本地分数很高,但换一段时间的数据就崩 | 改为按时间切分:训练集只用验证集时点之前的数据 |
| 分组泄露 | 同一个体(同一人、同一店铺、同一图片的多个裁切)同时落在训练和验证两侧 | 本地分数稳定虚高,与榜单差距大且不稳定 | 按”个体”而非按”行”划分,同一个体只能属于一侧 |
| 预处理泄露 | 在划分训练/验证之前,就用全量数据做了标准化、填充、编码等统计 | 差距不大但持续存在,最难被发现 | 所有依赖统计量的处理都放到划分之后,只用训练侧拟合 |
第四种最值得单独提醒。它不像前三种那样有明显破绽:只是把”算平均值填缺失”这一步放在了切分之前,验证集的信息就顺着平均值渗进了训练过程。很多学生的代码从第一天起就带着这个问题,且一路沿用到赛季结束。
三、泄露和”过拟合公开榜”不是一回事
这两件事常被混为一谈,但病灶与修法都不同。关键区别在于本地分数是否也被污染:过拟合公开榜时,本地验证通常仍是诚实的,只是你选择性地相信了榜单;泄露则连本地判据一起骗过去,更难自我纠正。
| 对比项 | 数据泄露 | 过拟合公开榜 |
|---|---|---|
| 本地验证分数 | 也被污染,同样虚高 | 通常正常,甚至偏低 |
| 公开榜分数 | 可能高,也可能不高 | 明显偏高 |
| 本地与榜单的关系 | 两边都不可信,无从判断 | 本地可信,榜单不可信 |
| 最终结算时 | 大幅回落 | 大幅回落 |
| 怎么修 | 回到数据和划分本身,删掉不该存在的信息 | 以本地验证为准做决策,不追榜单 |
| 能不能自己发现 | 难——症状是好消息 | 相对容易——两个分数会打架 |
实操含义很直接:如果本地和榜单同时好得反常,先怀疑泄露;如果只有榜单好而本地平平,先怀疑自己在追榜。前者要回到数据,后者要回到决策纪律。
四、提交前的四步自检
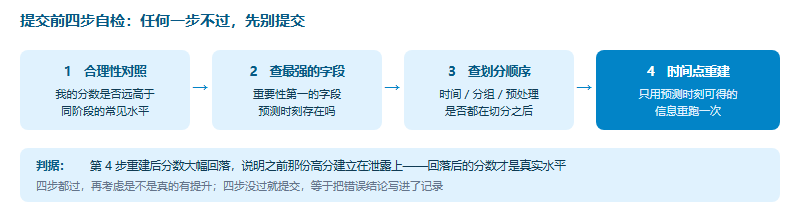
第 4 步值得展开:所谓时间点重建,是把自己放回”要做预测的那一刻”,只允许使用那一刻已存在的信息,重跑一遍完整流程。这会逼你回答平时含糊过去的问题——这个统计量什么时候算的?这个标签什么时候产生的?做完之后分数往往会掉,但掉下来的那个数字,才是可以拿去讨论的数字。
五、如果怀疑是比赛数据本身有泄露
有时问题不在学生的代码里,而在赛题给的数据本身。这种情况下有两条纪律:
- 先确认,再声张。拿出可复现的证据(最小示例、明确的字段与统计),在讨论区如实报告。这类帖子恰恰是讨论区里最有价值的内容之一。
- 能不能利用它,看规则页,不要靠推断。不同比赛对”使用赛题数据中的一切信息””引入外部数据”的规定并不相同,主办方有时也会更新数据或发布公告。以该赛事的规则页与官方公告为准,绝不要拿另一场比赛的经验来套——这是最容易踩线的地方之一。
还有一层是学术诚信:如果这段工作要写进 IB 的 IA、EE 或其它学校项目,把已知带泄露的结果当作有效结论呈现,性质就完全不同了。诚实的写法是把泄露当作发现本身写出来——”最初得到异常高的准确率,排查后定位到某字段泄露,修正后结果是⋯⋯”。这样的段落通常比一个站不住的数字更能体现研究能力。
六、家长视角:分数突然暴涨该怎么解读
如果孩子兴奋地说”我的分数突然特别高”,不需要懂技术也能问三句:第一,”这个提升是哪一次改动带来的?”——说得出具体一处改动的可以继续,说”改了好几个地方”的先回去把变量分开。第二,”你最重要的那个字段,在做预测的时候真的已经知道了吗?”——这句直指目标泄露。第三,”如果只用预测那一刻能拿到的信息,分数还剩多少?”
需要提醒的是:查出泄露不是坏事,而是能力的体现。能自己发现并说清”我为什么曾经错”的学生,比讲不清来龙去脉的学生走得更远。家长这一步最该做的是别把分数回落当成退步——回落之后的数字才是真的。想先了解平台整体结构的家长,可以从Kaggle 入门指南读起。
常见问答
Q:怎么快速判断本地分数是不是被泄露污染了?
A:最快的一招是看特征重要性排行。如果第一名的字段重要性远远压过其余所有字段,先问自己一句”做预测的那一刻,这个字段已经存在了吗”。答案是否定或说不清,基本可以确认是目标泄露。第二招是按时间或按个体重新划分一次,如果分数明显掉下来,说明原来的划分方式在骗你。
Q:预处理放在切分之前,影响真的有那么大吗?
A:影响大小取决于数据规模和处理方式,但方向是确定的——它会让本地分数系统性偏高,而且偏差稳定、不容易被发现。更重要的是它会污染你的判断依据:在一个虚高的基准上比较新特征,很容易得出错误结论。养成”先切分、统计量只在训练侧拟合再套用”的习惯,成本很低。
Q:发现比赛数据有泄露,可以拿来提分吗?
A:这完全由该赛事的规则页决定,不能凭其它比赛的经验推断。不同比赛对赛题数据的使用范围、外部数据的引入有各自的规定,主办方有时还会更新数据或发布公告说明处理方式。正确做法是先读规则页与官方公告,拿不准就在讨论区如实提问;同时把可复现的证据整理出来报告,这本身就是有价值的贡献。
Q:如果这段工作要写进学校项目,发现泄露之后该怎么写?
A:如实写进过程,不要删掉。推荐的写法是”最初结果异常好 → 排查过程 → 定位到泄露原因 → 修正后的真实结果 → 这件事说明了什么”。这样的叙述展示了排查能力和研究诚实度,通常比一个漂亮但经不起追问的数字更有说服力。反过来,明知有泄露仍把高分当作有效结论呈现,属于学术诚信问题。
本文由 Kaggle 中文编辑部发布,由翰林教育为中国国际学校学生运营;本站独立运营,不代表 Kaggle 或任何赛事主办方。各比赛对数据使用、外部数据与泄露处理的规定由主办方制定并会逐年调整,请以该赛事规则页与 kaggle.com 官方公告为准。如发现内容错误,我们将在 7 个工作日内更正。