直接回答:monotonic_cst 能做什么,不能做什么
在 Kaggle 数据科学竞赛中,尤其是涉及金融风控、信用评分或保险定价的表格型任务,参赛者经常面临一个核心矛盾:模型在训练集上表现优异,但预测结果违背了基本的业务常识。例如,信用分越高,违约概率理应越低;年龄越大,某些健康风险指标可能上升。树模型(如梯度提升决策树 GBDT)本质上是数据驱动的,它可能会因为样本噪声或局部相关性而学到相反的方向。
monotonic_cst 是 scikit-learn 中 HistGradientBoostingClassifier 和 HistGradientBoostingRegressor 提供的参数,允许用户将这种“单特征方向先验”写进模型。简而言之,它可以强制某个数值特征对预测结果的影响保持单调递增或递减。但是必须明确:monotonic_cst 不是 Kaggle 平台的官方评分规则,而是建模工具库的功能特性。此外,它存在严格的限制:不支持多分类问题,也不支持无序的类别特征。如果试图用它来约束多个特征的联合交互效应,不仅无法实现预期效果,还可能加剧欠拟合风险。
scikit-learn 文档定义:0、1 与 -1 的含义
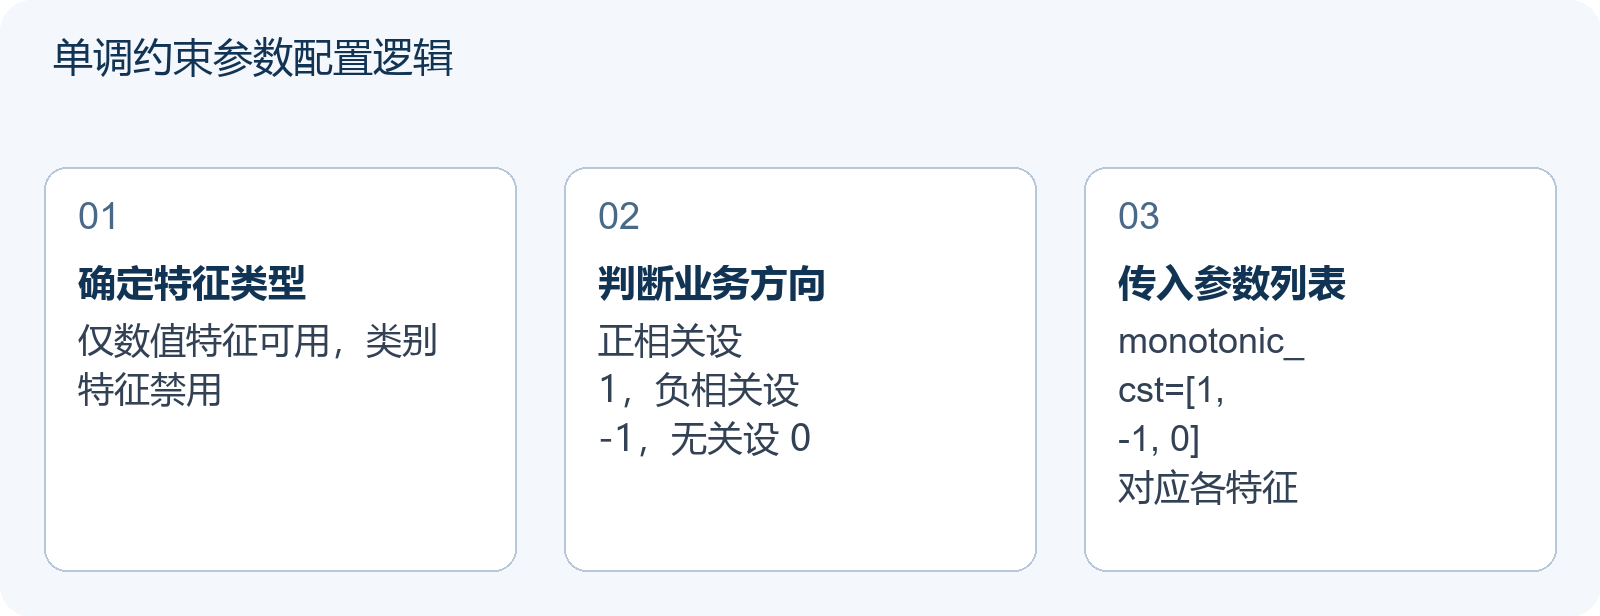
根据 scikit-learn 1.9.1 官方文档《1.11. Ensembles: Gradient boosting, random forests, bagging, voting, stacking》的定义,monotonic_cst 参数接受一个列表,长度等于特征数量。列表中每个元素对应一个特征的约束类型:
- 0:无约束。模型可以自由学习该特征与目标之间的任意非线性关系。
- 1:单调增加约束。对于回归问题,意味着特征值越大,预测值越大;对于二分类问题,意味着特征值越大,属于正类的概率越高。
- -1:单调减少约束。对于回归问题,意味着特征值越大,预测值越小;对于二分类问题,意味着特征值越大,属于正类的概率越低。
在二分类场景下,理解“正类概率”至关重要。通常我们将标签为 1 的样本视为正类(例如“违约”或“欺诈”)。如果业务逻辑认为“收入”越高,“违约”概率越低,那么应将收入特征的约束设为 -1。该约束在训练阶段被并入分裂过程:只有不违背所设方向的切分才会被采用,因此最终输出的概率或预测值会沿该方向保持单调。
教学假设示例:信用违约赛中的约束设置
注意:以下内容为教学假设,旨在演示操作流程,并非真实 Kaggle 比赛题目或官方数据。
假设在一个模拟的信用违约预测比赛中,我们使用 HistGradientBoostingClassifier 作为基线模型。数据集包含三个主要数值特征:credit_score(信用分)、income(年收入)和 age(年龄)。目标变量 default 表示是否违约(1=违约,0=正常)。
业务专家给出如下先验判断:
credit_score越高,违约概率应越低 → 设置约束为 -1。income越高,违约概率应越低 → 设置约束为 -1。age与违约的关系不确定,可能存在 U 型曲线(年轻人和老年人都高风险)→ 设置约束为 0(无约束)。
代码配置如下:
from sklearn.ensemble import HistGradientBoostingClassifier

# 假设特征顺序为 [credit_score, income, age]
gbdt = HistGradientBoostingClassifier(
    monotonic_cst=[-1, -1, 0],
    max_iter=100,
    learning_rate=0.1
)
gbdt.fit(X_train, y_train)
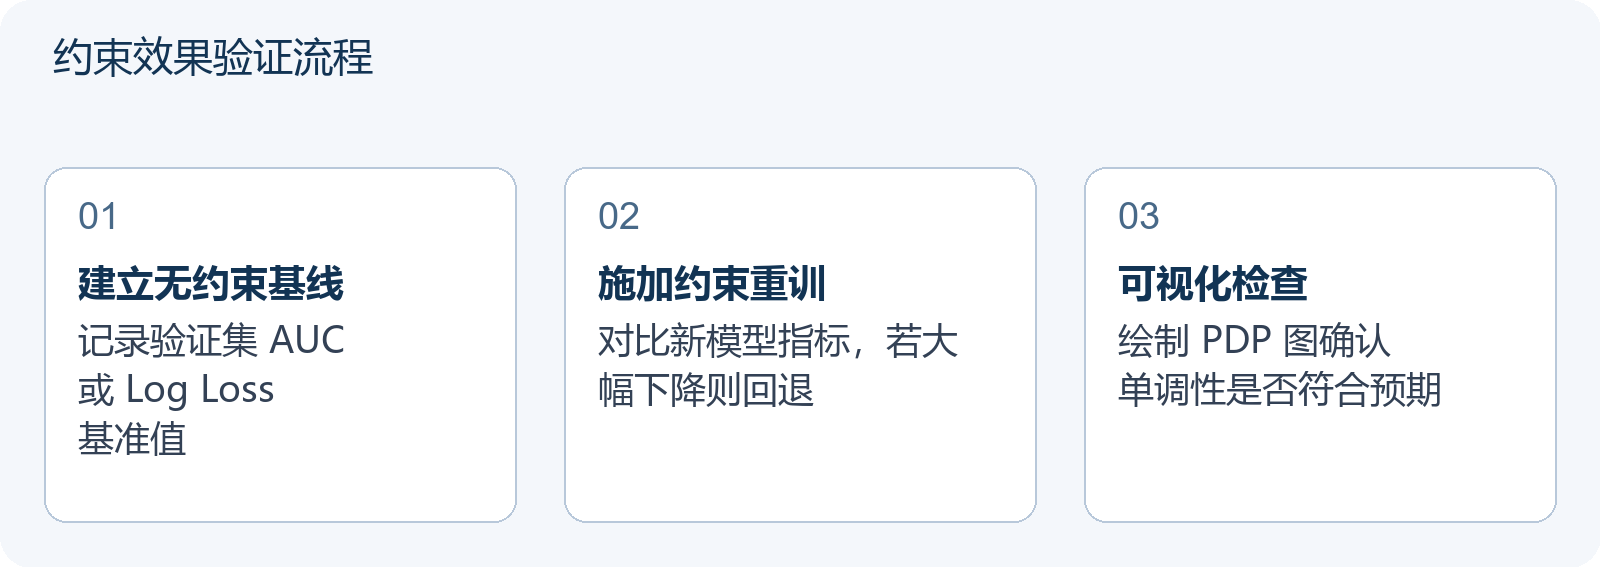
在实际操作中,不应盲目添加约束。正确的做法是先在验证集上比较加约束前后的指标(如 AUC 或 Log Loss)。如果加约束后验证集分数显著下降,说明业务先验可能与数据分布不符,或者约束过于严格限制了模型的表达能力。
限制一:多分类问题不支持单调约束
scikit-learn 文档明确指出:“Also, monotonic constraints are not supported for multiclass classification.”(此外,单调约束不支持多分类。)这意味着当你用 HistGradientBoostingClassifier 处理三个及以上类别的任务时,monotonic_cst 不适用。
原因在于多分类的输出是多个类别的概率向量,各类别之间没有统一的“正负”方向概念。例如在区分“猫”“狗”“鸟”的任务中,很难定义某个特征(如体重)对所有类别概率的单一单调影响。对于需要方向性先验的多分类任务,一种教学层面的工程做法是把问题拆解为多个二分类任务(One-vs-Rest),在每个二分类器上分别判断是否施加单调约束。这一做法需要在训练成本与各子模型概率一致性上做出取舍,属于工程建议,而不是 scikit-learn 文档规定的标准路径。
限制二:类别特征是无序量,不能施加单调约束
另一个常见误区是对类别特征(Categorical Features)使用 monotonic_cst。文档强调:“Since categories are unordered quantities, it is not possible to enforce monotonic constraints on categorical features.”(由于类别是无序量,因此不可能对类别特征施加单调约束。)
例如,特征 city 包含“北京”“上海”“广州”。这些字符串本身没有大小之分,即使将其映射为整数 0、1、2,这种顺序也是任意的。如果强行设置约束,模型会错误地认为“北京”到“上海”的变化具有某种数学上的单调意义,这完全违背了数据的语义。
HistGradientBoostingClassifier 原生支持类别特征(通过 categorical_features 参数指定),但它内部会将类别视为独立的离散值进行分裂,而不是连续轴上的点。因此,只有数值型特征才能参与单调约束的计算。如果需要对类别特征施加某种“有序”假设(如教育程度:小学<初中<高中),必须先将其转换为有序的数值编码(Ordinal Encoding),并确保转换后的数值确实反映了业务上的单调逻辑,然后才能对该数值列应用约束。
反例分析(教学假设):联合交互约束的误用与欠拟合
注意:以下情境为教学假设,用于说明机制,不代表任何真实赛题或官方结论。
许多参赛者希望表达更复杂的业务逻辑,例如:“当收入低时,年龄越大违约率越高;但当收入高时,年龄越大违约率越低。”这是一种联合交互约束(Joint Interaction Constraint)。
然而,monotonic_cst 只能施加边际约束(Marginal Constraints)。文档警告:“Monotonic constraints only marginally constrain feature effects on the output.”(单调约束仅边际约束特征对输出的影响。)这意味着它只控制单个特征变化时的整体趋势,无法捕捉特征之间的依赖关系。
如果试图用两个单独的单调约束来近似上述交互逻辑(例如设年龄为 +1、收入为 -1),模型会被强制要求在所有情况下都遵循这两个独立方向。在上述例子中,如果模型发现数据中存在“高收入 + 高年龄 = 低风险”的模式,但被强制要求“年龄越大风险越高”,它就会扭曲其他部分的预测以补偿这个错误,从而可能加剧欠拟合风险。
要表达这类联合逻辑,更实际的做法通常是让模型自行学习特征交互(即不施加单调约束,让树结构自然分裂),或先构造能刻画该交互的派生特征,再对派生特征单独设置方向。需要注意的是,scikit-learn 另有 interaction_cst 参数,但它控制的是“哪些特征之间允许产生交互”,与 monotonic_cst 的单调方向约束是两回事,不能用来实现上述联合单调条件。
实操流程:从业务假设到验证集测试
在 Kaggle 表格赛中合理使用单调约束,建议遵循以下四步流程:
| 步骤 | 操作内容 | 关键检查点 |
|---|---|---|
| 1. 梳理业务先验 | 列出所有数值特征,判断其与目标变量的理论方向(增/减/未知)。 | 避免主观臆断,参考领域文献或历史数据分布。 |
| 2. 初步建模 | 训练一个无约束的基线模型,记录验证集指标(AUC/Log Loss)。 | 确保基线模型已充分调参,排除欠拟合干扰。 |
| 3. 施加约束并对比 | 对确信度高的特征施加 monotonic_cst,重新训练并评估。 |
若指标下降超过自定阈值(如 0.5%),则撤销该约束。 |
| 4. 可视化验证 | 绘制部分依赖图(PDP)或个体条件期望图(ICE)。 | 直观检查约束特征是否真的呈现单调趋势,且未破坏其他特征的解释性。 |
值得注意的是,单调约束有时能提高泛化能力,因为它减少了模型对噪声的过拟合。但如果业务先验本身有误,约束就会成为枷锁。因此,始终保留“不加约束”的版本作为对照实验。
相关资源与进一步阅读
在处理 Kaggle 表格赛问题时,除了模型本身的约束设置,还需要关注特征取舍与验证策略。以下是本站相关的深度指南:
- 关于如何判断新增特征是否真正有用,请参考Kaggle特征消融实验:怎样判断新增特征是真的有用。单调约束是否值得保留,同样需要一版有约束、一版无约束的对照证据。
- 在决定是否融合多个模型时,错误互补性比单纯的性能更重要,详见Kaggle模型集成:先检查错误是否互补,再决定要不要融合。有时一个带约束的模型与一个无约束模型形成互补,可以平衡偏差与方差。
- 分组交叉验证对于防止数据泄露至关重要,特别是在时间序列或用户维度数据中,参见Kaggle分组交叉验证:同一用户出现在训练集和验证集怎么办。错误的验证划分会让你误判单调约束的真实效果。
结论
monotonic_cst 是 Kaggle 表格赛中处理业务先验的有力工具,但它是一把双刃剑。它适用于二分类和回归任务中的数值特征,不适用于多分类和无序类别特征。最关键的限制在于它只能施加边际约束,无法处理复杂的联合交互逻辑。成功的秘诀在于严谨的验证流程:始终在验证集上对比有无约束的表现,并利用可视化工具确认模型行为符合预期。不要为了追求“可解释性”而牺牲模型的预测精度,除非你能证明约束带来的泛化收益大于其造成的偏差损失。
一般活动背景信息可参见scikit-learn 集成学习文档。
常见问题
单调约束能替代交叉验证吗?
不能。单调约束是一种正则化手段,用于注入先验知识,而交叉验证是评估模型泛化能力的统计方法。两者目的不同,必须结合使用:在交叉验证的不同折叠上分别测试有约束和无约束模型的表现,以确定约束是否提升了稳定性。
施加单调约束能保证业务可解释性吗?
不一定。单调约束仅保证单个特征对输出的边际影响方向正确,但不能保证整个模型的逻辑完全符合人类直觉,特别是当存在复杂的特征交互时。可解释性还需要结合 SHAP 值、部分依赖图等工具进行综合诊断。
为什么我的多分类模型说不支持单调约束?
因为 scikit-learn 文档说明 HistGradientBoostingClassifier 的多分类模式不支持 monotonic_cst 参数。如果你需要处理多分类且想引入方向性约束,一种教学层面的工程做法是把问题拆解为多个二分类任务(One-vs-Rest),在每个子任务中分别判断是否施加约束,同时接受由此带来的训练成本与子模型一致性代价。