直接回答:使用GroupKFold或类似分组策略,确保同一用户的全部记录要么全进训练集、要么全进验证集。标准KFold会让同一用户同时出现在两侧,导致验证分数虚高,提交后公开榜大幅下跌。
问题本质:为什么”同一用户”会破坏验证可信度
许多Kaggle竞赛数据集存在用户级聚类:一个用户有多条记录,这些记录共享高度相似的特征分布。如果随机拆分,模型会在验证阶段”提前看到”该用户的部分信息,验证分数比真实泛化能力更乐观。
典型场景包括:
- 电商推荐:同一买家的浏览/购买历史
- 医疗数据:同一患者的多次检查记录
- 金融风控:同一账户的多笔交易
- 内容平台:同一作者的多篇文章
这类问题与Kaggle Notebook 公开前该检查什么?从代码规范到学术诚信的七项自检(2026)中强调的”理解数据结构后再建模”原则直接相关——若跳过数据探索阶段,极易忽视用户ID的分布特征。
假设教学案例一:正确的GroupKFold用法
【教学演示,非官方赛题】假设你正在处理一个用户行为预测数据集,包含以下字段:
| 字段 | 说明 |
|---|---|
| user_id | 用户唯一标识(分组依据) |
| timestamp | 行为发生时间 |
| feature_1 ~ feature_n | 行为特征 |
| target | 预测目标 |
步骤演示
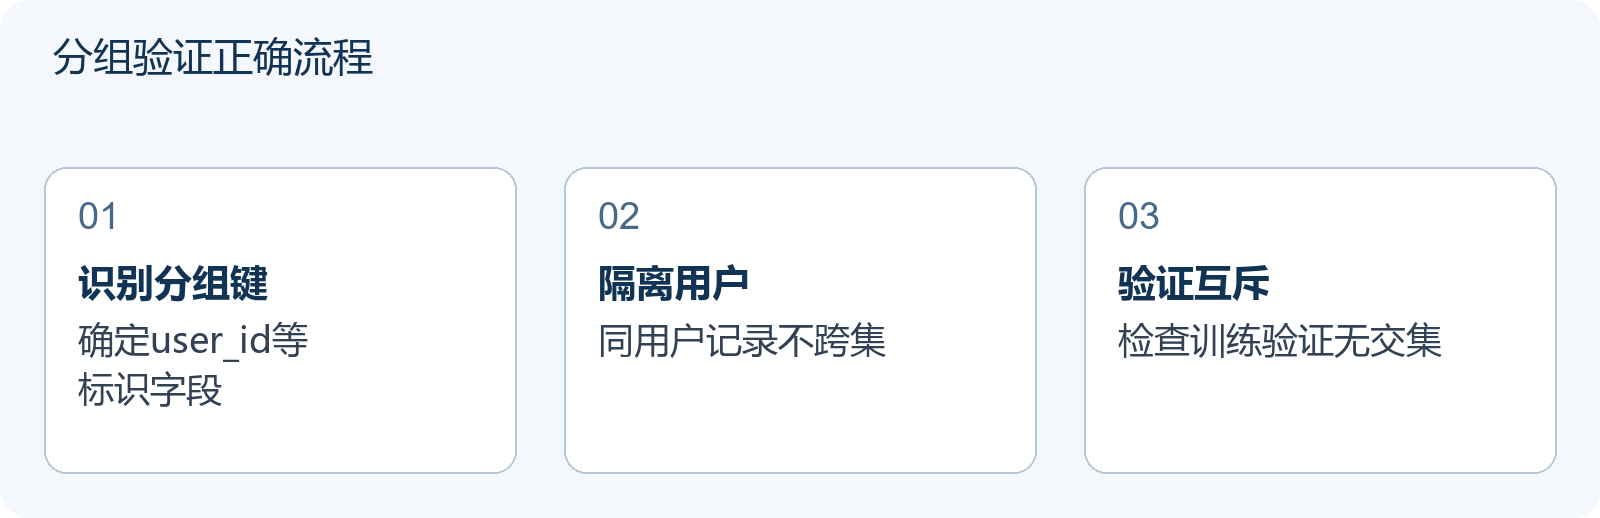
步骤1:识别分组变量
首先确认user_id的分布。假设10万条记录来自2万个独立用户,平均每个用户5条记录。
步骤2:配置GroupKFold
使用scikit-learn的GroupKFold,将user_id作为groups参数传入:
from sklearn.model_selection import GroupKFold

gkf = GroupKFold(n_splits=5)
for train_idx, val_idx in gkf.split(X, y, groups=df['user_id']):
    # 同一用户的所有记录只出现在train或val之一
    model.fit(X.iloc[train_idx], y.iloc[train_idx])
    preds = model.predict(X.iloc[val_idx])
    # 评估...
步骤3:验证分组效果
检查任意一个fold:确认val_idx中的user_id与train_idx无交集。可用以下代码快速验证:
train_users = set(df.iloc[train_idx]['user_id'])
val_users = set(df.iloc[val_idx]['user_id'])
assert len(train_users & val_users) == 0, "分组失败,存在交集"
此案例中,本地验证分数与最终提交分数的差距通常更小且更稳定。
假设教学案例二:常见错误与诊断
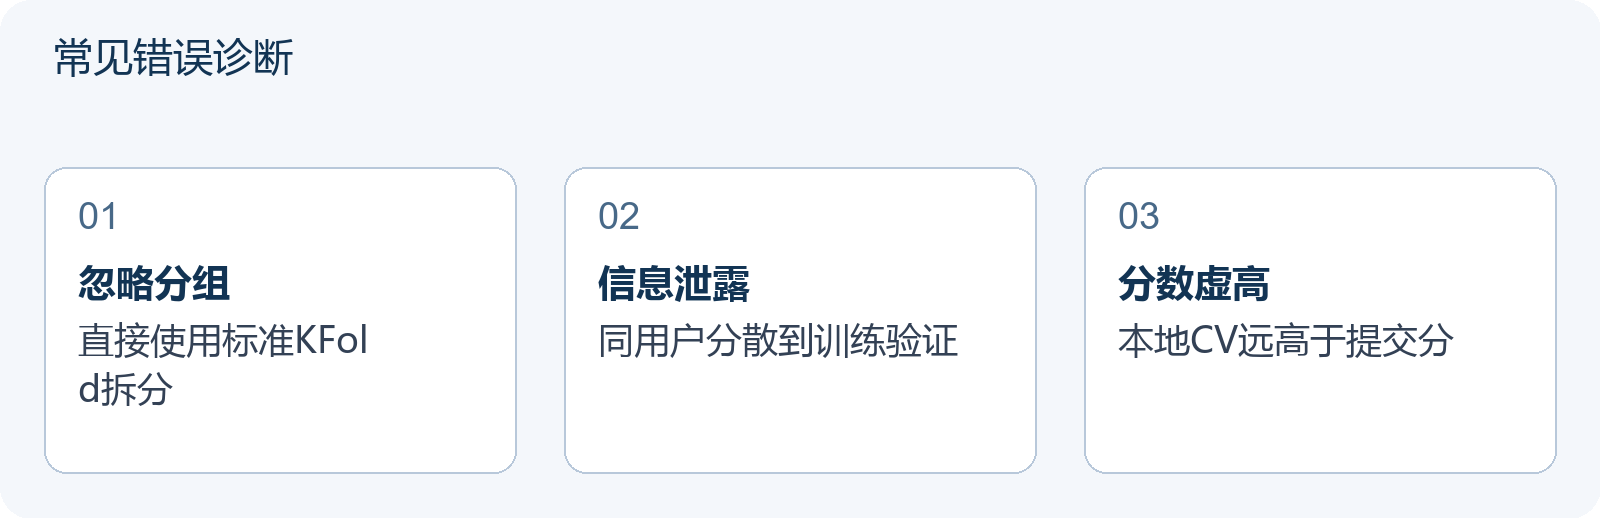
【教学演示,非官方赛题】假设一位参赛者未识别出user_id的分组意义,直接使用标准KFold:
from sklearn.model_selection import KFold  # 错误选择

kf = KFold(n_splits=5, shuffle=True, random_state=42)
for train_idx, val_idx in kf.split(X):  # 未传入groups
    ...
错误后果
假设用户U有5条记录,标准KFold随机拆分后可能出现:
| 记录 | 归属 | 问题 |
|---|---|---|
| U_1, U_2, U_3 | 训练集 | 模型学到U的行为模式 |
| U_4, U_5 | 验证集 | 验证时”认出”U,分数虚高 |
结果:本地CV分数显著高于真实泛化能力,提交后公开榜大幅下跌。
诊断对比表
| 检查项 | 正确做法(GroupKFold) | 错误做法(KFold) |
|---|---|---|
| 分组依据 | 明确指定groups参数 | 忽略groups |
| 用户分布 | 训练/验证用户完全互斥 | 同一用户可能同时出现 |
| 本地CV与提交差距 | 差距小且稳定 | 差距大且波动 |
| 时间序列场景 | 需额外考虑时间顺序 | Shuffle破坏时序 |
关于评分指标的具体计算方式,可参考Kaggle 评分指标详解:Accuracy、Log Loss 与对数 RMSE 的三个算例中的算例分析。
可用实践决策
面对新竞赛数据时,建议按以下顺序排查:
- 检查是否存在潜在分组变量(user_id, patient_id, account_id等)
- 统计该变量的唯一值数量与记录数的比例
- 若比例显著低于1(如2万用户/10万记录=0.2),强烈考虑分组策略
- 验证分组后各fold的用户分布是否均衡
- 对比分组CV与标准CV的分数差异,差异大说明分组必要
如需系统了解Kaggle竞赛的账号准备与规则要求,可参考Kaggle 注册:新手参赛前的账号、验证与规则准备清单(2026)。
核心要点回顾
遇到用户级聚类数据时,务必用GroupKFold替代标准KFold,并通过验证训练/验证集用户互斥性来避免信息泄露,使本地CV分数真正反映模型泛化能力。
常见问题
如果数据中没有显式的用户ID字段,还需要分组验证吗?
需要检查是否存在隐式分组。例如,同一设备、同一IP段、同一地理位置在短时间内产生的记录可能高度相关。可通过特征聚类或时间窗口分析识别潜在分组结构。
GroupKFold和StratifiedKFold可以一起用吗?
可以,但需使用StratifiedGroupKFold或手动实现。核心原则是同时满足:同一组只出现在单一fold,且各fold的目标类别比例与总体一致。注意并非所有场景都能完美满足两个约束,需根据数据规模权衡。
分组后某些fold的用户数差异很大怎么办?
这是GroupKFold的固有限制——它追求组级别互斥而非样本数均衡。若用户记录数差异极大,可考虑:1) 先对用户做分层抽样再分组;2) 使用更灵活的自定义分组策略;3) 评估时采用加权指标而非简单平均。