榜单分数不同,是因为 Kaggle 评分指标不只问预测对不对,还问概率或数值误差。Accuracy 只看硬分类;Log Loss 看正确类别概率;对数 RMSE 看预测值与真实值在自然对数尺度上的偏差。
同样预测对 8/10,意味着两个模型的硬分类正确数相同。若指标只数对错,榜单可能接近;若指标看概率质量或数值误差,榜单就会拉开。本文用三个小样本逐行演算,帮助把榜单读数与本地验证对齐。本站已有《Kaggle 比赛页怎么读?Overview、Evaluation、Rules 与评价指标入门》讲指标类别,《第一次提交之后怎么提分》讲流程顺序,《数据泄露四种形态》讲泄露自检;本文不复述这些,只聚焦指标如何读数、怎么拿同一指标做本地验证、指标不能单独决定切分方案。
Kaggle 官方竞争赛文档说明,预测赛使用隐藏真值、评价指标与自动评分;Public 与 Private 是不同测试子集,具体比例和规则逐场不同。因此每场比赛应看其 Evaluation 与 Rules,具体赛题的 Evaluation/Rules 高于通用例子。
先给一张可摘引的核对表
下面三个算例都是教学小样本,不是 Kaggle 榜单真实分数。它们只回答“指标在读什么”。
| 指标 | 读数 | 本文小样本 | 不能推出 |
|---|---|---|---|
| Accuracy | 硬分类正确数 / 总数 | 4/4 = 1.000 | 概率校准好 |
| Log Loss | 正确类别概率损失 | 0.9 对应 0.1054;0.6 对应 0.5108 | 所有分类赛都用它 |
| 对数 RMSE | ln 尺度偏差 | 0.1005 | 所有回归赛通用指标 |
一、Accuracy:只看对错,不看信心
Titanic 官方赛页写明目标为二分类,提交 0/1,评价指标是 Accuracy,即正确数除以总数。这个事实只适用于该例,不能推广为“所有分类赛都用 Accuracy”。
| 样本 | 真实标签 | 硬预测 | 是否正确 |
|---|---|---|---|
| 1 | 1 | 1 | 是 |
| 2 | 0 | 0 | 是 |
| 3 | 1 | 1 | 是 |
| 4 | 0 | 0 | 是 |
| 合计 | — | — | 4/4 |
小样本真实标签为 1,0,1,0。模型 A 和 B 都给出硬预测 1,0,1,0,因此 Accuracy 都是 4/4。若换算成 8/10,只要正确数仍是 8,Accuracy 仍是 0.8。Accuracy 不会区分“很确定地正确”和“刚好压线地正确”。
对 Kaggle 验证集来说,Accuracy 的本地读数很简单:把预测标签与真实标签逐行比较,数正确个数,再除以样本总数。但它也很容易掩盖概率质量:两个模型可以同样 4/4,却一个很确定、一个很犹豫。
二、Log Loss:同样 4/4,概率质量可差很多
Log Loss 是分类概率指标,scikit-learn 指标文档列出它。本文用教学演算,不声称当前 Titanic 用 Log Loss。二元 Log Loss 常用形式为:
Log Loss = -1/n Σ [y_i ln(p_i) + (1-y_i) ln(1-p_i)]
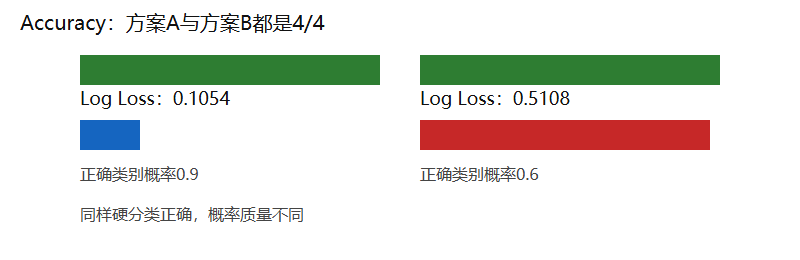
这里 p_i 是正类概率。真实标签 1,0,1,0。方案 A 给正确类别概率 0.9,即正类概率分别为 0.9、0.1、0.9、0.1;方案 B 给正确类别概率 0.6,即正类概率分别为 0.6、0.4、0.6、0.4。两方案硬预测都正确,Accuracy 都是 4/4。
| 真实 y | 正确类别概率 | 正类概率 p | 硬预测 | 方案A损失 | 方案B损失 |
|---|---|---|---|---|---|
| 1 | 0.9 / 0.6 | 0.9 / 0.6 | 1 | 0.1054 | 0.5108 |
| 0 | 0.9 / 0.6 | 0.1 / 0.4 | 0 | 0.1054 | 0.5108 |
| 1 | 0.9 / 0.6 | 0.9 / 0.6 | 1 | 0.1054 | 0.5108 |
| 0 | 0.9 / 0.6 | 0.1 / 0.4 | 0 | 0.1054 | 0.5108 |
| 平均 | — | — | 4/4 | 0.1054 | 0.5108 |
方案 A 平均损失 0.1054,方案 B 平均损失 0.5108。因此同样 4/4 Accuracy,概率质量仍可不同。若两个模型都预测对 8/10,Kaggle Log Loss 读数也可能拉开差距。
Log Loss 会惩罚“错误但自信”的预测。即使样本最终被硬分类判对,只要正确类别概率不够高,损失也会上升。因此,如果比赛 Evaluation 写明使用概率指标,本地验证就不能只算 Accuracy,而要保留概率列并用同一公式算分。
scikit-learn 文档列出 log_loss 等分类指标,可作为本地实现参考;但具体比赛是否使用它,仍以该场 Evaluation 为准。
三、对数 RMSE:不是普通原价 RMSE
House Prices 官方赛页说明评价是在房价预测值的自然对数与真实值的自然对数之间算 RMSE。不要把它写成普通原价 RMSE,也不能说它是所有回归赛通用指标。
教学小样本:真实价 100000、200000,预测价 110000、180000。误差用 ln(预测) - ln(真实)。
| 真实价 | 预测价 | ln(预测)-ln(真实) | 平方 |
|---|---|---|---|
| 100000 | 110000 | +0.0953 | 0.0091 |
| 200000 | 180000 | -0.1054 | 0.0111 |
| 对数RMSE | — | — | 0.1005 |
对数 RMSE = sqrt((0.0953^2 + (-0.1054)^2) / 2) = 0.1005
它衡量的是比例误差,而不是绝对金额误差。以上仅教学示例,不是 Kaggle 榜单真实分数。
Kaggle RMSE 读数关键在“先取自然对数”。如果本地直接拿原价预测和原价真实值算 RMSE,得到的数字与比赛指标不是同一件事。小样本中,真实价 100000、预测价 110000 的 ln 误差为 +0.0953;真实价 200000、预测价 180000 的 ln 误差为 -0.1054。两者平方后平均再开方,得到 0.1005。
这并不表示所有回归赛都用它;House Prices 只是官方明确使用该自然对数 RMSE 的例子。
四、指标不能单独决定切分方案
指标决定“算哪种误差”,不能单独决定“验证集怎么切”。这是编辑解释,不称 Kaggle 官方硬规则。时间序列需考虑时间顺序,同一实体重复出现需考虑组别泄露;具体方案取决于数据结构,不能只看指标名。
例如,若比赛数据按日期采集,随机切分可能把未来样本放进训练、过去样本放进验证,本地分数看起来漂亮,提交后却不稳定。若同一实体在数据中多次出现,随机切分可能让同一实体同时进入训练与验证,导致指标读数虚高。此时即使你完全复刻了 Log Loss 或对数 RMSE 公式,本地验证集也可能不匹配比赛。
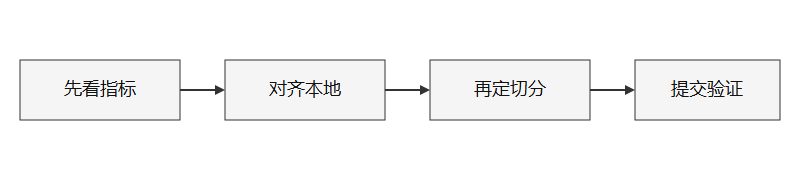
五、实操:先看指标→对齐本地 scoring→再定切分→提交验证
- 先看指标:打开该场 Evaluation 与 Rules,确认是 Accuracy、Log Loss、对数 RMSE,还是其他指标。具体赛题的 Evaluation/Rules 高于通用例子。
- 对齐本地 scoring:在本地验证集上用同一公式或同一库函数算分。例如分类概率赛用 sklearn.metrics 中的 log_loss;房价赛若采用自然对数 RMSE,就先把预测与真实都取 ln,再算 RMSE。
- 再定切分:指标只决定“算哪种误差”,不能单独决定“验证集怎么切”。时间序列需考虑时间顺序,同一实体重复出现需考虑组别泄露;具体方案取决于数据结构,不能只看指标名。这是编辑解释,不是 Kaggle 官方硬规则。
- 提交验证:提交后把 Public 变化当作反馈,但不把 Public 当唯一真理。Public 与 Private 是不同测试子集,比例和规则逐场不同。
六、指标读数:三个常见误判
第一,Accuracy 高不等于概率校准好。Log Loss 会惩罚过度自信:正确类别概率 0.6 的损失明显高于 0.9。
第二,RMSE 前缀不同,数字不可直接比较。普通原价 RMSE 与对数 RMSE 的单位和尺度不同。House Prices 的教学数字 0.1005 只是示例,不是 Kaggle 榜单真实分数。
第三,本地分数与榜单分数不一致时,先检查三件事:指标公式是否一致、概率列是否取对、验证集切分是否匹配比赛数据结构。若只是指标类别入门,可回到站内《Kaggle 比赛页怎么读?Overview、Evaluation、Rules 与评价指标入门》;若流程顺序不清,看《第一次提交之后怎么提分》;若怀疑泄露,看《数据泄露四种形态》。
小结:先读指标,再读数据
同样预测对 8/10,榜单分数仍可能不同:Accuracy 只数正确硬分类,Log Loss 看概率质量,对数 RMSE 看自然对数尺度偏差。本地验证要复刻同一指标,切分方案则要看时间顺序与组别泄露。指标名不是切分方案,公式对齐也不等于数据对齐。
常见问题
Q1:同样 8/10 Accuracy,为什么 Log Loss 仍可能不同?
因为 Accuracy 只数正确硬分类,Log Loss 还会看正确类别概率。概率越接近 1,损失越低;概率只到 0.6,损失会明显升高。
Q2:House Prices 能直接用普通 RMSE 做本地验证吗?
不能照搬。官方赛页说明它在预测值与真实值的自然对数之间算 RMSE。本地 scoring 应先取 ln,再算误差平方均值并开方。
Q3:指标决定验证集怎么切吗?
不单独决定。指标决定算哪种误差;切分要看数据结构。时间序列要尊重时间顺序,同一实体重复出现要防止组别泄露。这是编辑解释,不是 Kaggle 官方硬规则。
本站为独立学习指南,与 Kaggle/Google 无隶属关系。