直接回答:第一次做数据项目时,不要只按下载量或标题热度选择 Kaggle 数据集。先做四项可用性检查:你能否用一句话定义任务;数据质量是否支撑最小模型;验证方式是否能复现且避免泄露;资源边界是否匹配你的时间和设备。四项中任意一项过不了,换数据集通常比硬做更省时间。
为什么热门数据集不一定适合第一次数据项目?
热度是社区行为信号,不是项目适配信号。一个数据集很多人下载,可能因为话题有趣、比赛出名或 Notebook 很多;但对第一次独立项目来说,真正重要的是你能否在有限时间内完成“问题定义—数据清洗—基线建模—验证记录—结果解释”这条链。热门页面有时候已经给出很完整的示例,学生容易直接复制结果,却没有练到问题定义和验证设计。反过来,一些下载量不高的表格数据集,如果字段清楚、目标变量明确、样本量适中,反而更适合作为第一个项目。
因此,选择 Kaggle 数据集时,建议把“我想做什么”写在前面,再把数据集页面当成证据清单来读:有没有标签列,字段说明是否足够,样本规模是否合理,能否设计验证,计算量是否可控。下面先写一句可验证的问题,再逐项检查。
先写一句可验证的问题:目标变量、评价方式、交付物
在下载数据之前,先写一句完整的问题陈述。它至少包含三个要素:目标变量、评价方式和交付物。教学示例:假设你选择一个公开房价表格数据集,可以写成“用房屋特征预测房价,目标变量是 price,评价方式用 MAE 或 RMSE,交付物是一份可复现 Notebook 和一张预测结果表”。这句话不追求学术创新,但必须能被验证。
如果只能写出“分析一下这个数据集”或“看看有什么规律”,说明问题还太模糊。模糊问题会导致后面每一步都无法判断对错:特征工程做完不知道是否更好,模型换完不知道是否真的提升,最后只能看公开 Notebook 的分数。对第一次项目,先写一句可验证的问题,是最低成本的风险控制。
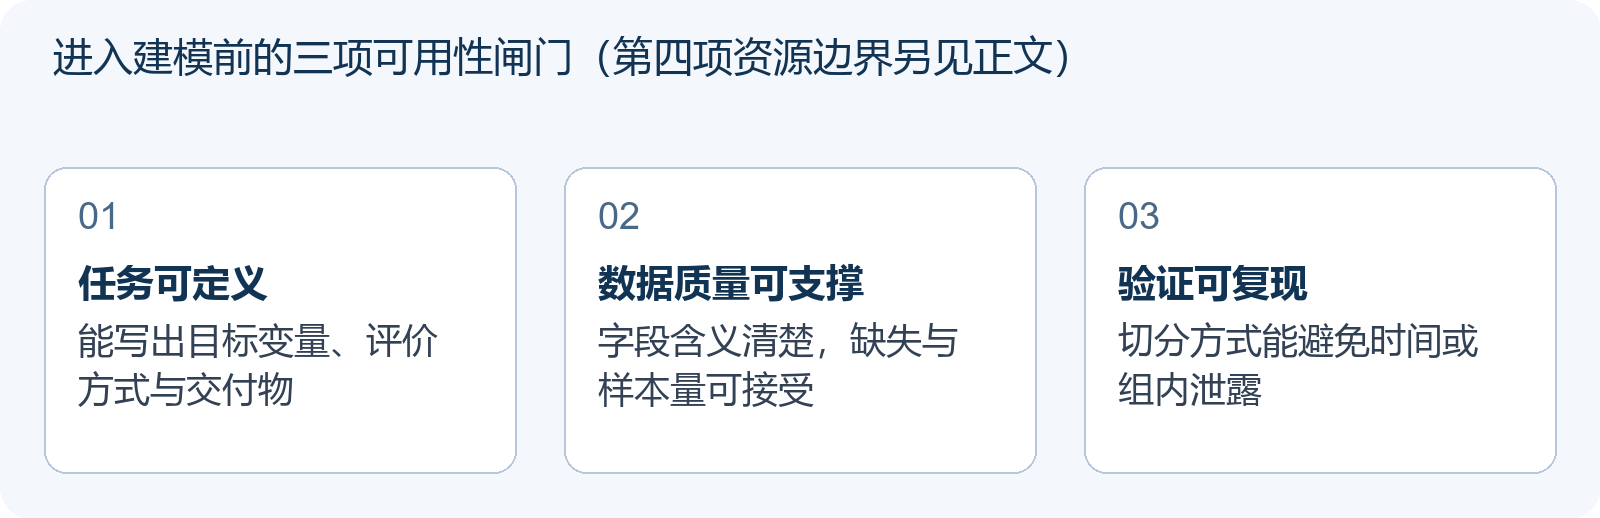
四项可用性检查之一:任务是否可定义
第一项检查是任务可定义性。打开数据集页面后,先找目标列或标签列。有监督任务需要明确标签;如果没有标签,你要判断能否用业务逻辑构造代理标签。教学示例:用户行为表没有“流失”列,但你可以定义“连续 30 天未登录”为流失,这就是代理标签。若无法构造合理代理标签,这个数据集更适合无监督练习,例如聚类、降维或异常检测,而不是直接做有监督预测。
还要检查 ID 列、时间列和目标列的关系。如果 ID 或时间与目标高度相关,可能存在泄露风险。对第一次项目,优先选择目标变量清楚、字段含义可解释的数据集,不要一上来就挑战标签模糊、需要大量外部知识才能定义任务的数据。
四项可用性检查之二:数据质量是否支撑
第二项检查是数据质量。用 Pandas 读取后,先打印 shape、dtypes、缺失值比例、重复行数和目标变量分布。若关键字段缺失超过一半,填补策略会变得高度主观,结果解释也会变弱。若样本只有几百行,复杂模型很容易过拟合;此时应优先使用简单模型、强正则化或交叉验证,而不是直接上深度学习。
异常值也要看,但不要机械删除。先判断异常值是录入错误、真实极端事件,还是目标泄露。文本字段还要看噪声比例和编码问题。高质量数据集不是“完全没有缺失”,而是缺失模式可解释、字段含义清楚、样本量足够支撑一个最小基线。若数据质量需要大量外部资料才能理解,第一次项目很容易卡在清洗阶段。
四项可用性检查之三:验证是否可复现
第三项检查是验证方案能否复现。随机切分不是万能答案。如果同一用户、同一设备或同一门店出现多次,随机切分可能把同一实体的信息同时放进训练集和验证集,导致验证分数虚高;此时应考虑分组切分。若是时间序列,随机切分也可能高估效果,应按时间顺序切分。关于不同赛题类型的验证思路,可参考 表格、图像、文本、时序:Kaggle 四类赛题的能力地图与选型指南(2026)。
你还需要区分比赛页和数据集页。比赛页通常给出 Evaluation 与 Rules,而数据集页往往需要你自己定义指标和切分方式;读比赛页的方法可参考 Kaggle 比赛页怎么读?Overview、Evaluation、Rules 与评价指标入门(2026)。如果数据集结构让你无法设计可信验证,那么再热门也不适合作为严肃的模型评估练习。
四项可用性检查之四:资源边界是否匹配
第四项检查是资源边界。考虑文件大小、格式、预处理时间和你的设备。CSV 通常最容易处理,Parquet 更高效但需要额外库,JSON 嵌套结构需要解析成本。图像、音频或大规模文本数据集可能超出本地电脑的舒适区,需要云端环境或更长的迭代周期。对第一次项目,能在一台普通笔记本上快速完成一轮“读取—清洗—建模—验证”的数据集,通常比超大但做不完的数据集更有价值。
时间边界同样重要。若你每周只能投入几小时,却选择一个需要数小时预处理的数据集,项目会迅速失去节奏。选择数据集时,把“最小可交付版本”写下来:一张图、一个基线分数、一份验证记录,都是有效产出。
教学示例(非真实竞赛):从数据集页到最小 Notebook 的检查清单
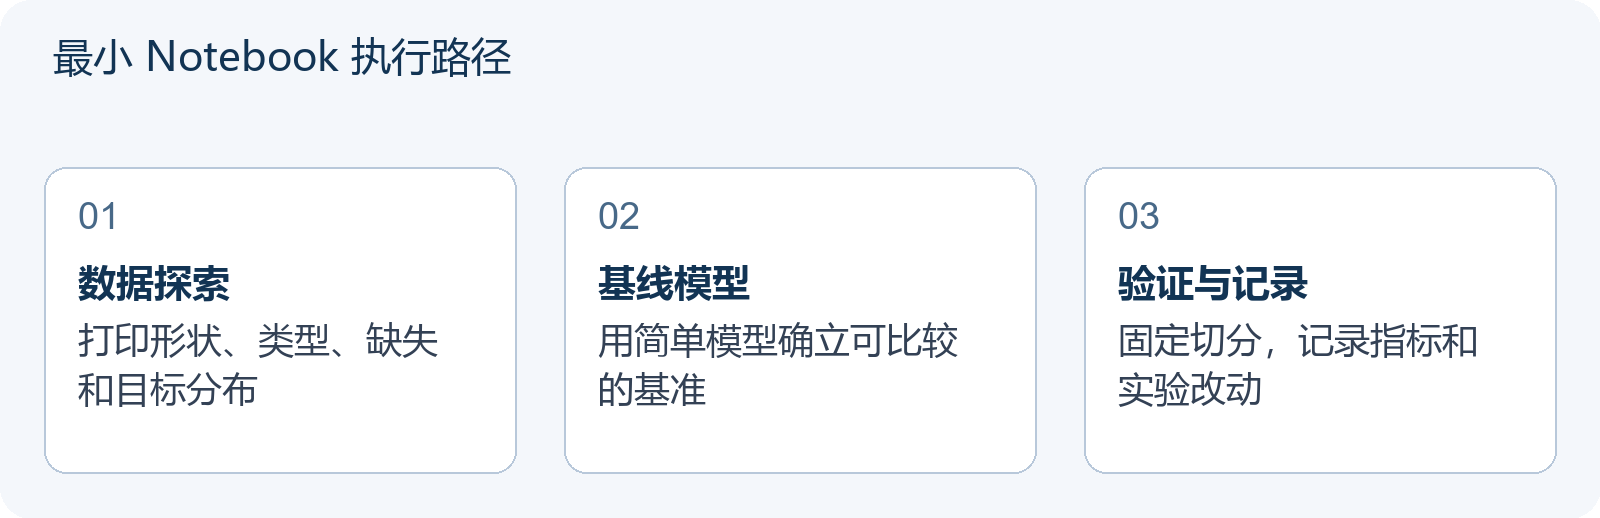
假设你找到一个公开表格数据集,有 5,000 行、一个明确目标列、少量缺失值和几个类别字段。第一步,读取 CSV,打印 shape、dtypes 和目标分布,确认样本量够做训练集/验证集切分。第二步,用简单模型建立基线,例如线性回归或决策树,并记录验证指标。第三步,检查特征与目标的异常关系,确认没有 ID 泄露或时间泄露,再把实验写入 Notebook 的 markdown 记录。这个示例只是教学说明,不是任何真实竞赛题,也不代表真实评分标准。
如果基线结果很差,先不要急着换复杂模型。依次检查:标签是否错位,缺失值处理是否引入噪声,验证切分是否合理,目标变量是否需要变换。很多第一次项目的失败不是模型不够强,而是数据集选择阶段就没有确认任务和验证方式。
常见误区:只下载不看字段说明、直接套公开 Notebook
第一个误区是忽略字段说明。不知道每一列的业务含义,就无法判断特征工程是否合理。第二个误区是直接复制公开 Notebook。复制能快速得到分数,但跳过了数据探索和验证设计,学习价值很低。第三个误区是在测试集上调参,或用未来信息构造特征。第四个误区是只看准确率,不看类别分布和错误类型。选择 Kaggle 数据集时,应把这些误区前置成检查项,而不是等做完才后悔。
数据集项目与比赛项目的差别
比赛项目通常有明确 Evaluation、Rules 和提交格式,你主要围绕给定指标优化。独立数据集项目则需要你自己定义问题、指标、切分和交付物。自由度更大,但责任也更大:你必须解释为什么这个指标合理,为什么这个验证方式可信,为什么结果不是泄露造成的。对希望展示完整研究过程的学生,独立项目更能体现从问题到解释的链条;但它要求你在选择数据集时更谨慎。
把数据集选择写进学习计划:每周可完成的最小里程碑
第一周:选定 2 到 3 个候选数据集,分别写出任务陈述,完成初步 EDA,淘汰无法定义目标或无法验证的候选。第二周:为最终候选建立基线模型,固定验证方案,记录首次实验结果。第三周:做一轮特征工程或数据清洗对比,保留实验记录表,说明每次改动的原因。第四周:整理 Notebook,写出限制、错误分析和下一步改进点。每个里程碑都要有可见产出,而不是只停留在“看了很多资料”。
与学校作业和学术诚信的衔接
如果数据集准备用于 IB IA、EE、AP Research 或其他学校作业,选择阶段还要考虑来源标注、许可说明和引用方式。把 Kaggle 数据集用进学校研究时,建议参考 把 Kaggle 数据集用进 IB IA、EE 与 AP Research:许可、来源与学术诚信三道关(2026)。本文只讨论项目可用性,不替代学校老师或课程大纲对引用与许可的要求。
需要外部反馈时,如何保持边界
如果你在选择数据集或设计验证时卡住,可以寻求外部反馈。本站提供一对一 Kaggle 辅导咨询,适合用来检查问题定义、验证设计和实验记录是否清楚;辅导不设班型、不公开价格,也不提供代写、代跑或代提交,更不承诺名次或奖项。你可以通过页脚二维码添加企业微信顾问,咨询 Kaggle 一对一备赛辅导。真正有价值的辅导,是帮你把四项检查做扎实,而不是替你跳过选择与验证。
常见问题
如果数据集没有标签怎么办?
可以判断能否构造代理标签,例如用连续 30 天未登录定义流失;若无法合理构造,就转向聚类、降维或异常检测等无监督任务。
样本量太小会影响模型吗?
会。小样本更容易过拟合,验证波动也更大;应优先用简单模型、正则化和交叉验证,而不是直接上复杂模型。
如何判断验证方式是否合理?
检查是否存在时间泄露或组内泄露,并确认验证集模拟真实使用场景的数据分布;同一用户多次出现时考虑分组切分。