直接回答:在Kaggle竞赛中,让特征、参数与验证结果一一对应的核心方法是建立结构化的实验日志系统——每次实验只改变单一变量,为每个实验分配唯一ID,并强制记录特征集合、模型参数、随机种子与验证分数的四元组。没有这套机制,你很快会陷入”上周某个配置好像更好但找不到了”的困境。
为什么实验管理是Kaggle提分的隐性门槛
很多新手把Kaggle当成”试出来的艺术”:改一行代码、跑一遍、看看分数,凭记忆决定下一步。这种模式的崩溃点出现在三个场景:一是三天后发现某个旧版本的特征组合其实更优,但代码已经覆盖;二是团队合并方案时,两人对”当前最优”的定义基于不同的验证切分;三是比赛最后一周,面对二十多个历史版本完全无法判断哪个值得最终提交。
竞赛社区对可复现性的共识已经体现在平台基础设施中。Kaggle Notebook的版本历史、版本控制机制,以及竞赛规则中对代码可复现性的要求,都指向同一个底层需求:实验管理不是锦上添花,而是高效提分的基础设施。相关实践可参见Kaggle Notebook 公开前该检查什么?从代码规范到学术诚信的七项自检(2026)中的完整检查框架。
核心机制:四元组记录法
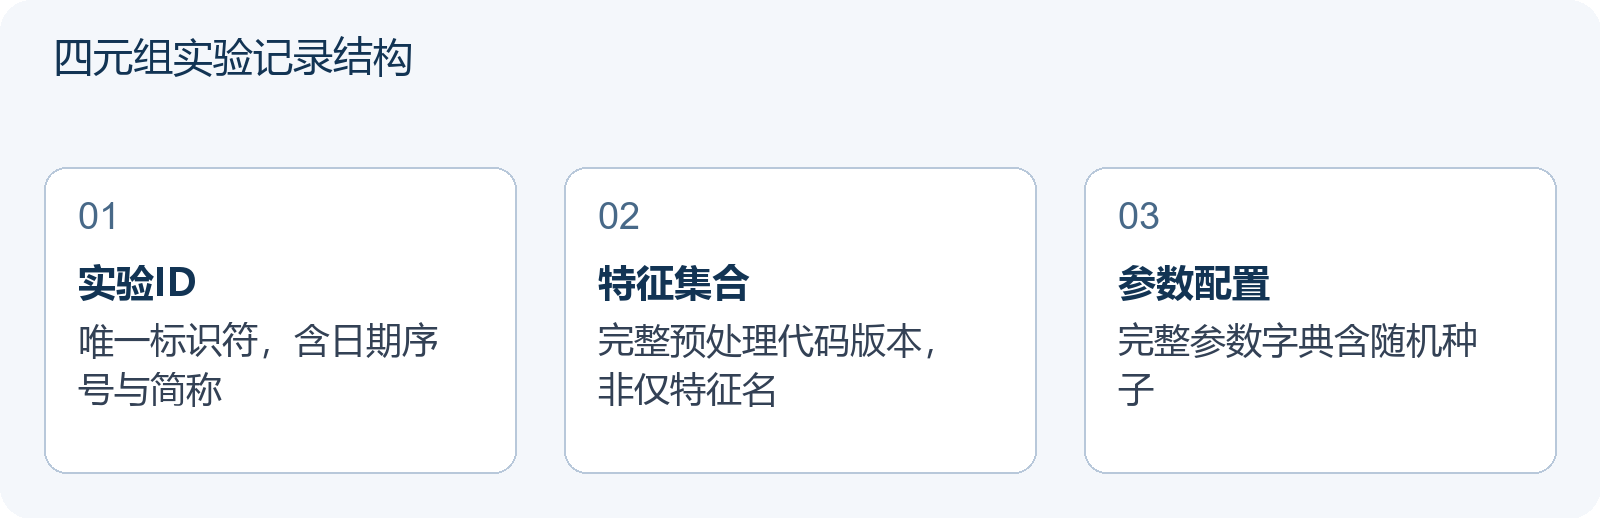
让实验可追溯的最小可行结构是实验ID → 特征集合 → 参数配置 → 验证结果的四元组。具体执行时:
- 实验ID:采用”日期_序号_简称”格式,如20261012_03_lgb_baseline,确保全局唯一且可读
- 特征集合:记录特征工程代码的版本哈希或完整代码,而非仅特征名的MD5(特征名MD5无法复现实际变换)
- 参数配置:保存完整的模型参数字典,包括常被忽略的random_state
- 验证结果:记录交叉验证的均值、标准差,以及各折的具体分数
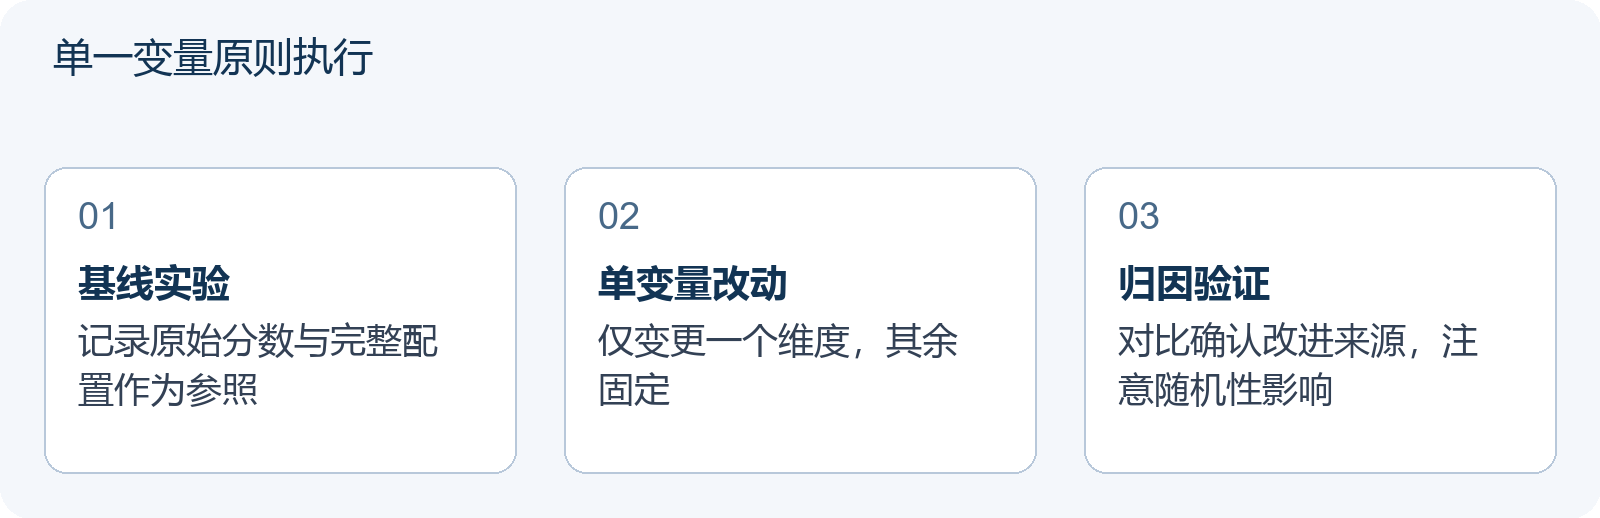
关键原则是单一变量原则:每次实验只改变四元组中的一个维度,便于诊断性比较。若需探索多因素交互,应设计清晰的多因素实验方案,而非随意叠加改动。
教学案例:一个被正确追踪的特征工程实验
【教学说明:以下数值均为虚构示例,用于演示计算与记录方法】
假设你在做一个房价预测竞赛,当前baseline使用原始数值特征,本地交叉验证RMSE为0.1450。你计划尝试加入交互特征。
实验 20261012_01_baseline
- 特征集合:原始数值特征(特征数:12)
- 参数配置:LGBM默认参数,random_state=42
- 验证结果:CV RMSE = 0.1450 ± 0.0032(±为折间标准差SD)
实验 20261012_02_add_interaction
- 特征集合:原始数值特征 + 面积×房间数交互项(特征数:13)
- 参数配置:LGBM默认参数,random_state=42(保持不变)
- 验证结果:CV RMSE = 0.1421 ± 0.0035
实验 20261012_03_tune_lr
- 特征集合:同实验02(特征数:13)
- 参数配置:learning_rate=0.05(原0.1),random_state=42(仅改此参数)
- 验证结果:CV RMSE = 0.1410 ± 0.0041
验证计算:实验02相对01的改进为0.1450 – 0.1421 = 0.0029,实验03相对02的改进为0.1421 – 0.1410 = 0.0011。两次差异可比较,但受随机性和潜在交互影响,不可简单相加为”总改进0.0040″。消融分析测量的是模型预测表现贡献,而非现实中的因果效应。
对比案例:实验记录缺失导致的决策陷阱
假设另一位参赛者做了以下操作,但没有记录系统:
周一:加了交互特征,同时把LGBM的n_estimators从100调到200,看到CV RMSE从0.145降到0.140。兴奋地认为”交互特征很有效”。
周三:尝试去掉交互特征但保留n_estimators=200,CV RMSE变成0.138——反而更好。此时才意识到周一的改进主要来自树的数量增加,而非交互特征。
周五:想复现周三的结果,但记不清当时是否还调了其他参数。重新跑了一遍,得到0.141,与记忆不符,陷入调试。
这个对比案例的逻辑漏洞在于混淆变量:n_estimators和交互特征同时改变,导致无法归因。更隐蔽的风险是记忆偏差:人类对”有效操作”的记忆具有选择性,无记录时极易高估某些策略的价值。此外,若反复用同一交叉验证挑选最优模型,该CV过程本身也会过拟合。实验管理的价值不仅是存档,更是防止自我欺骗。
完整复现所需的六要素
仅有实验ID和分数不足以复现结果。完整的实验记录还应包括:
- 数据版本:原始数据文件的版本或下载时间戳
- 预处理代码:特征变换的完整代码,而非仅输出特征名
- 依赖版本:关键库(如scikit-learn、lightgbm)的版本号
- 切分ID:交叉验证的切分方式与随机种子,或预先生成的切分文件标识
- 指标定义:评估指标的具体计算公式(如RMSE是否取对数、是否按样本加权)
- 种子+执行结果:随机种子与完整的输出日志
这些要素共同构成可复现的最小单元。缺少任何一项,”复现”都可能沦为猜测。
诊断应用:你的实验管理健康度检查
以下三个问题可快速诊断当前实验管理的健康程度:
问题一:能否在5分钟内找到两周前任意一次实验的完整配置?
如果答案是否定的,说明你的实验记录分散在Jupyter Notebook的单元格输出、终端历史或大脑记忆中。建议立即建立一个CSV或简单的实验记录表,字段即四元组加六要素。
问题二:能否确定当前最优模型的验证分数是基于哪种交叉验证策略?
时间序列问题中,随机K折和时间滑窗的验证分数不可比较。若记录中未标注验证策略,可能出现”用时间滑窗选的模型,在随机K折上反而更差”的误判。相关细节可参考Kaggle时间序列验证:随机切分为什么可能高估模型效果中的方法讨论。
问题三:团队成员是否使用相同的实验命名约定?
组队场景下,”final_v3_fix”这类命名是灾难。建议团队共享一个实验ID生成规则,或使用统一的实验记录模板。
从诊断到行动:下一步该做什么
诊断结果对应三类行动路径:
若健康度低(无法回答问题一):优先建立最小可行记录系统。不需要复杂工具,一个结构化的CSV文件配合git版本控制即可。关键是立即开始记录当前实验,而非等”有空了再整理历史”。
若健康度中等(能回答问题一但无法回答二或三):补充验证策略标注和团队协作规范。此时引入轻量级工具的收益最高,因为基础设施意识已经具备。
若健康度高(三个问题都能回答):将实验管理升级为特征消融实验的系统化流程。即不仅记录”加了什么”,还要有计划地”减去什么”来验证每个特征的真实贡献。具体方法可参考Kaggle特征消融实验:怎样判断新增特征是真的有用中的完整工作流。
与相关方法的边界区分
实验管理与特征消融实验常被混淆,但两者解决不同问题:
- 实验管理回答”每次实验做了什么、结果如何”,是过程追溯问题
- 特征消融回答”某个特征是否真正提升模型”,是贡献度量问题
没有实验管理,特征消融无法执行——你无法在混乱的记录中定位基线。但仅有实验管理也不够,还需要系统性地移除特征来测量边际贡献。两者结合,才能形成从”记录”到”决策”的完整闭环。
另一个易混淆点是分组交叉验证中的实验管理。当同一用户的数据可能同时出现在训练集和验证集时,验证分数本身就会失真,此时无论实验记录多完整,结论都不可靠。这类场景需要特殊的验证策略设计,详见Kaggle分组交叉验证:同一用户出现在训练集和验证集怎么办。
常见误区与纠正
误区一:”我用的Notebook自动保存了,不需要额外记录”
Notebook保存的是代码状态,而非”这个代码版本对应哪个验证分数”。除非你为每次运行手动命名并记录结果,否则自动保存无法替代实验管理。
误区二:”实验记录太麻烦,比赛结束后再整理”
比赛期间的决策依赖实时反馈,事后整理无法挽回已经错过的优化方向。且人类记忆快速衰减,”赛后整理”往往变成”无法整理”。
误区三:”我只用默认参数,不需要记录参数”
即使默认参数,不同库版本也可能不同(如scikit-learn的默认solver在版本更新中变化)。记录完整的参数字典,包括”这是默认参数”的声明,才能确保可复现。
准备咨询前的自我梳理
如果你计划就Kaggle备赛寻求进一步指导,建议先整理以下信息,这将使咨询更高效:
- 当前正在参加或计划参加的具体竞赛名称与类型(表格/图像/文本/时序)
- 已有的实验记录样本(即使不完整也可),包括特征数量、模型类型、验证分数
- 遇到的具体瓶颈:是分数停滞、无法复现历史结果,还是团队协作混乱
- 可用的计算资源与时间投入(每周可投入小时数)
这些信息将帮助判断是需要从零建立实验管理流程,还是在现有基础上优化特征消融或验证策略。
常见问题
实验管理需要用什么工具?必须花钱吗?
不需要。最小可行的实验管理可以只用CSV文件配合git版本控制。工具的价值在于降低记录摩擦,但核心原则是”记录”本身而非工具选择。
我已经有很多历史实验没记录,需要补录吗?
不建议花大量时间补录。优先从当前实验开始严格执行记录,对重要历史版本(如当前最优模型)尽量回忆补录关键信息。补录的准确性无法保证,不应作为决策依据。
组队时如何协调实验管理?
团队应共享实验命名规则和记录模板,使用统一的项目空间(如共享云盘)。关键约定包括:实验ID前缀区分负责人、禁止覆盖他人实验记录、合并方案前必须核对双方的实验基线是否一致。