对于许多数据科学爱好者和学生而言,Kaggle 注册是进入竞赛世界的第一步。然而,真正的挑战往往不在于点击“注册”按钮,而在于理解平台机制、遵守社区规范以及高效利用学习资源。作为一个独立的中文指导站点,我们不提供官方账号服务,但我们可以为你梳理一套在 Kaggle 注册前后应当完成的准备清单,帮助你更从容地开启第一次比赛。
一、 为什么“准备”比“注册”更重要?
很多新手在 Kaggle 注册后急于下载数据集或提交代码,却忽略了两个关键点:一是账号的合规性,二是对特定赛事规则的深度理解。根据本站过往对大量新手案例的分析,失败往往源于对“公开榜”与“最终榜”机制的误解,或是未仔细阅读某项赛事特有的提交格式要求。因此,在正式投入时间之前,建立一个结构化的准备流程至关重要。
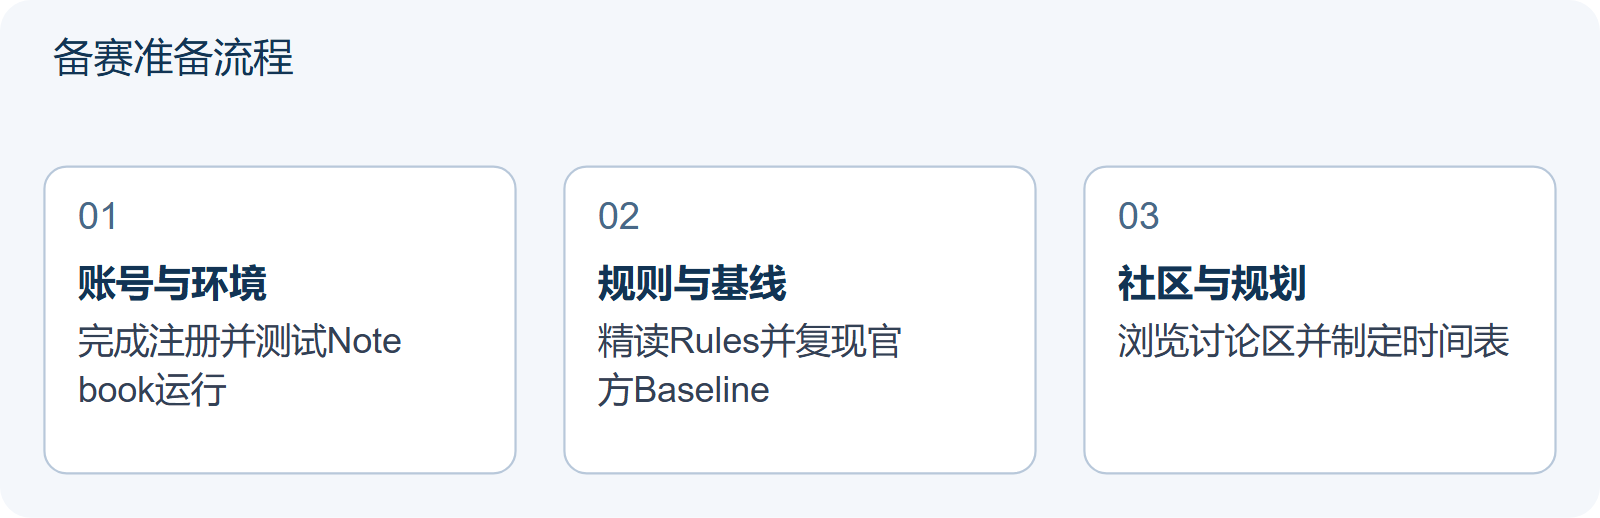
二、 新手参赛前的五步准备清单
以下清单并非 Kaggle 官方的强制规定,而是基于最佳实践总结的建议步骤:
| 步骤 | 行动内容 | 目的 |
|---|---|---|
| 1. 环境自查 | 确认网络访问稳定性,熟悉 Notebook 界面基本操作。 | 避免因技术环境问题导致提交失败。 |
| 2. 规则精读 | 逐字阅读目标赛事的 Rules 页面,特别是关于数据泄露和外部数据的限制。 | 防止因违规被取消资格。 |
| 3. 基线复现 | 尝试运行官方提供的 Baseline Notebook,确保能成功输出预测文件。 | 验证账号权限及提交流程是否通畅。 |
| 4. 社区浏览 | 查看 Discussion 板块中关于该赛事的高赞问题与解答。 | 提前规避常见陷阱,获取优化思路。 |
| 5. 时间规划 | 设定每日学习目标,区分探索期与冲刺期。 | 保持长期竞争力,避免最后时刻崩溃。 |
三、 如何利用本站资源辅助备赛?
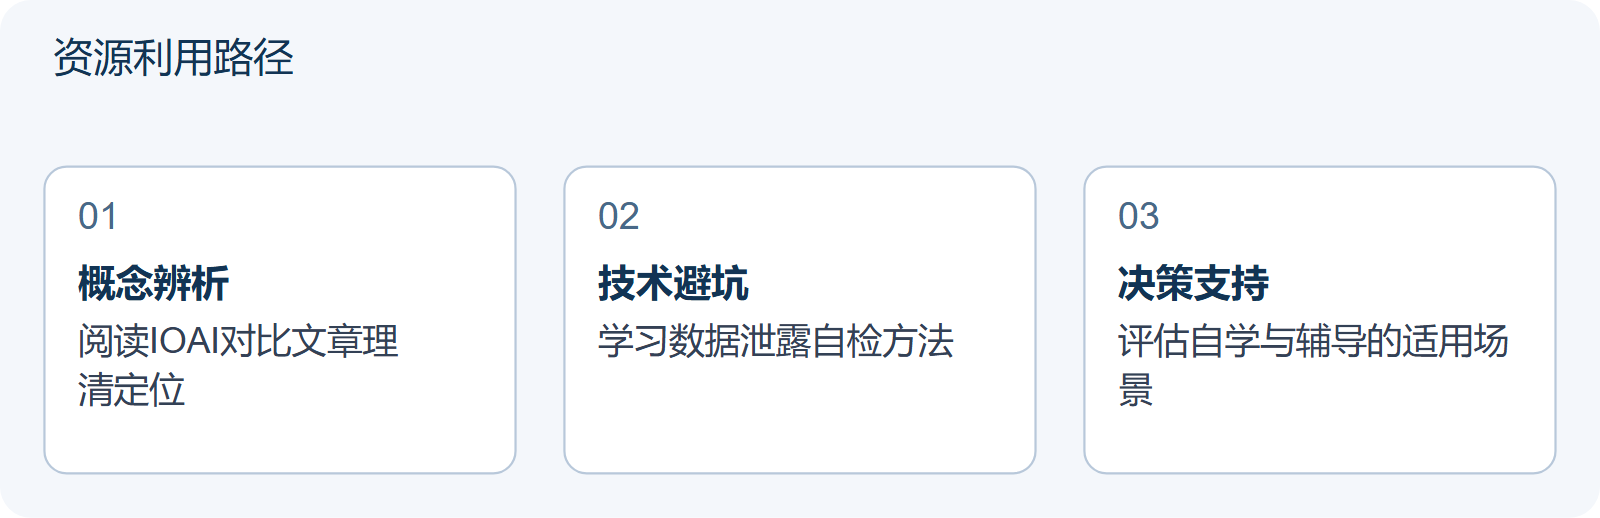
本站作为非官方的独立指南,致力于提供高质量的中文解读。在完成基础的 Kaggle 注册后,你可以参考我们的Kaggle 和人工智能奥赛 IOAI 有什么不同?赛制、评分、参赛资格与先后顺序(家长版·2026)来理解不同竞赛体系的差异。此外,针对具体的技术难点,如数据泄露问题,推荐阅读分数高得不像真的?Kaggle 数据泄露的四种形态与提交前的四步自检(2026),这篇文章详细拆解了新手最容易忽视的逻辑漏洞。
如果你正在考虑是否需要外部指导,可以参考Kaggle 要不要找人带?自学够用的情况、带教的真实增量与八个评估问题(家长版·2026)。我们强调一对一的深度辅导而非批量课程,旨在帮助学生建立独立的科研思维,这与 Kaggle 鼓励自主探索的精神是一致的。
四、 常见误区提醒
在 Kaggle 注册及后续操作中,请警惕以下误区:
- 盲目追求高分:在未理解评测指标(Metric)的情况下刷分,可能导致模型过拟合于公开榜。
- 忽视版本控制:不记录每次提交的改动原因,导致无法回溯最佳模型。
- 混淆账号类型:虽然个人账号足以应对大多数比赛,但若涉及团队赛,需提前了解组队规则及成员邀请流程。
总之,Kaggle 注册只是起点。通过系统化的准备、对规则的敬畏以及对资源的合理利用,你才能在激烈的竞争中稳步提升。希望这份清单能为你的第一次 Kaggle 之旅提供清晰的方向。
五、 决策演练:面对“外部数据”诱惑时的取舍逻辑
在 Kaggle 竞赛中,新手最常面临的抉择并非算法调优,而是如何处理“外部数据”。许多参赛者认为引入更多数据必然提升模型性能,但这一假设往往忽略了规则合规性与泛化能力的风险。为了帮助读者将前文提到的“规则精读”与“基线复现”转化为实际决策能力,以下提供一个假设性/说明性的备赛场景。请注意,此案例仅用于演示思维过程,不涉及任何真实赛事的具体规定或结果。
场景设定:假设你正在参加一个图像分类比赛,官方数据集包含 10,000 张标注图片。你在网上发现了一个开源的大型通用图像库,其中包含约 50,000 张未标注但类别相似的图片。此时,你有两个选择:
选项 A(激进策略):立即下载该外部库,使用半监督学习技术扩充训练集,试图通过增加数据量来强行压低损失函数。
选项 B(稳健策略):暂停数据扩充,先严格检查比赛规则中关于“外部数据”的定义,并尝试在不引入新数据的情况下,优化现有数据的预处理流程(如增强、清洗)。
决策分析:
若选择 选项 A,虽然可能短期内在公开排行榜上获得高分,但存在巨大隐患。首先,若规则禁止使用特定来源的外部数据,你的提交可能被判定违规;其次,通用图像库的分布可能与测试集存在偏差(Domain Shift),导致模型在最终私有榜上表现不佳,出现“过拟合公开榜”的现象。此外,处理 50,000 张图片需要额外的计算资源和时间,可能挤占调试核心模型的时间。
若选择 选项 B,虽然看似保守,但能确保账号安全与模型稳定性。通过深入理解现有数据的特征,你可以更精准地设计数据增强策略,从而在不违反规则的前提下提升模型的鲁棒性。这种策略更符合“准备比注册更重要”的理念,即优先保证合规性与基础质量,再追求边际收益。
什么改变了决策?
关键在于对评测指标机制的理解。如果比赛强调“最终排名”且存在严格的隐私或版权限制,选项 B 是绝对优选。反之,若规则明确允许使用公共领域数据,且你已验证外部数据与测试集分布一致,选项 A 才具备可行性。因此,改变决策的核心变量不是“数据量的大小”,而是“规则的边界”与“分布的一致性”。
可复用的自检清单:
在面对类似的数据扩充诱惑时,请依次回答以下三个问题:
1. **合规性检查:** 我是否逐字阅读了 Rules 页面中关于 External Data 的条款?是否有明确的许可声明?
2. **分布一致性:** 外部数据的来源、分辨率、标签定义是否与官方训练集高度一致?是否存在潜在的域偏移风险?
3. **成本效益比:** 引入这些数据所需的时间成本(清洗、对齐、训练)是否高于直接优化现有模型所能带来的预期增益?
| 评估维度 | 倾向选项 A (引入外部数据) | 倾向选项 B (深耕内部数据) |
|---|---|---|
| 规则清晰度 | 规则明确允许且无版权争议 | 规则模糊或禁止使用非官方数据 |
| 数据匹配度 | 外部数据与测试集分布高度相似 | 外部数据存在显著域偏移风险 |
| 资源状况 | 算力充足,有专门团队处理数据 | 单人参赛,算力有限,需快速迭代 |
常见问题
本站提供 Kaggle 官方账号注册服务吗?
不提供。本站是独立的中文指导站点,非 Kaggle 官方运营网站。我们仅提供备赛知识、规则解读和学习资源指引,用户需自行前往 Kaggle 官网完成注册。
新手第一次打比赛应该先做什么?
建议在完成基础注册后,优先选择一个入门级比赛(如 Titanic),重点在于完整走通“读取数据-构建模型-生成提交文件-上传”的流程,而非立即追求排名。
如何判断是否需要参加辅导?
若你在自学过程中遇到难以突破的技术瓶颈,或缺乏系统的实验方法论,可参考本站关于辅导价值的分析文章进行评估。辅导应侧重于思维引导而非代劳。