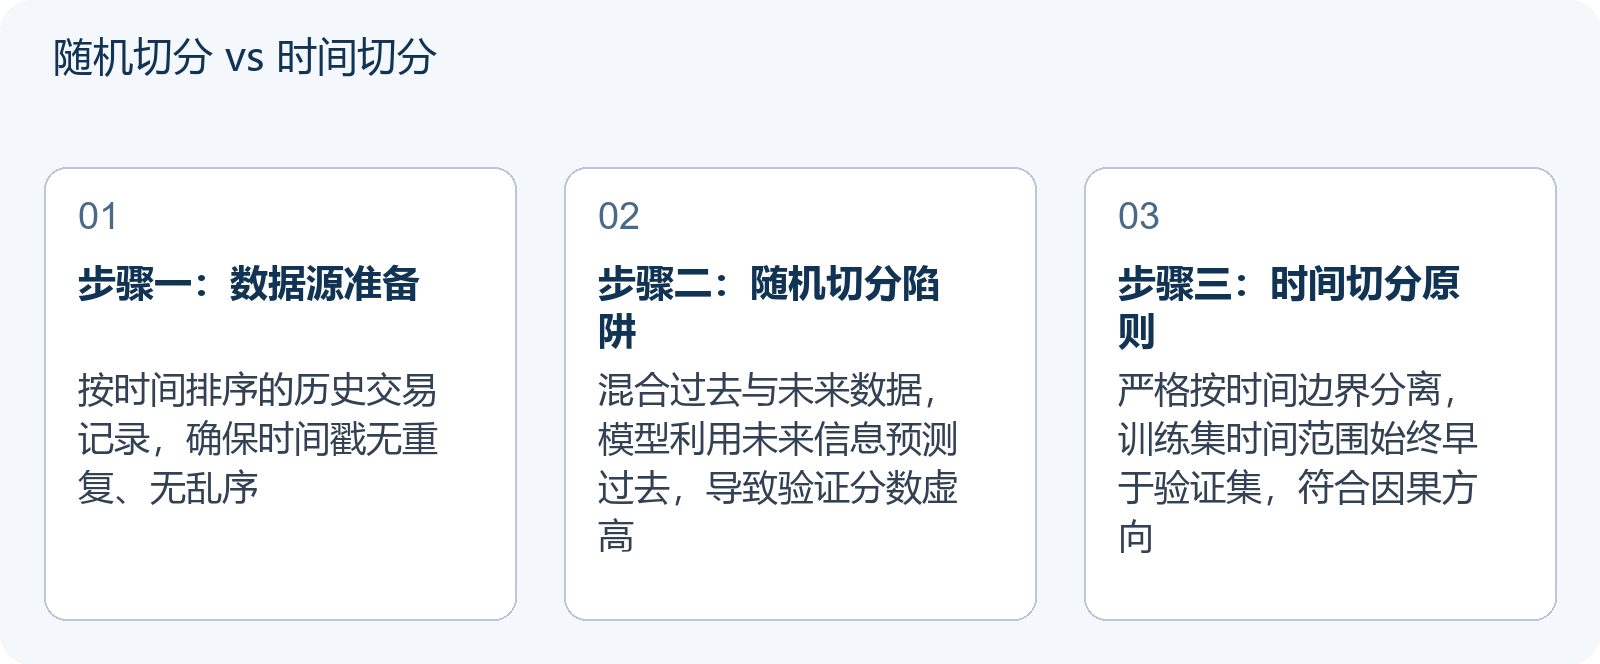
直接回答:在Kaggle涉及时间序列(如股票预测、销量预估、用户行为分析)的竞赛中,使用随机切分(Random Split)进行交叉验证通常会严重高估模型效果。这是因为随机切分允许模型利用“未来”的数据来预测“过去”或“现在”,违反了时间因果律。正确的做法是采用按时间顺序切分(Time-based Split),确保训练集的时间始终早于验证集。
为什么随机切分会失效?
许多新手参赛者习惯使用 sklearn.model_selection.train_test_split 并设置 shuffle=True。对于独立同分布(IID)的数据(如图像分类、静态表格特征),这是标准操作。然而,时间序列数据具有自相关性(Autocorrelation)和趋势性(Trend)。如果将第10天的数据放入训练集,而将第5天的数据放入验证集,模型实际上是在用“已知结果”去推导“未知原因”,这在现实部署中是不可能发生的。
教学演示一:零售销量预测中的“作弊”现象
【说明:以下案例为教学演示,非真实竞赛题目或官方数据,数值为示意性质。】
假设有一个假设性的 Kaggle 竞赛任务:预测某超市未来一周的牛奶销量。数据集包含过去两年的每日销售记录。
- 错误做法:随机抽取80%的行作为训练集,20%作为验证集。
- 结果:模型在验证集上表现异常出色,误差远低于预期。
- 原因分析:由于是随机切分,验证集中某一天的数据(例如2024年6月1日)可能在训练集中存在其前后几天的数据(例如2024年5月31日和6月2日)。模型学会了利用邻近时间的强相关性来“插值”预测,而不是真正理解季节性或趋势。
- 实际后果:当模型上线预测2024年7月的数据时,由于缺乏“未来”邻居数据的支持,性能断崖式下跌。
教学演示二:用户流失预测中的滞后效应
【说明:以下案例为教学演示,非真实竞赛题目或官方数据,数值为示意性质。】
另一个假设场景是电信公司的用户流失预测。特征包括用户过去3个月的通话时长、账单金额等。
- 错误做法:对所有用户样本进行随机分层抽样。
- 结果:模型评估指标异常理想,看似非常可靠。
- 原因分析:某些用户的流失是一个渐进过程。如果用户A在第1个月开始减少通话,第2个月投诉,第3个月流失。随机切分可能将第1、2个月的数据放入训练集,第3个月的结果放入验证集。这相当于让模型看到了“前兆”并确认了“结果”,属于典型的数据泄露。
- 正确视角:应该以“观察窗口”结束时间为基准,确保用于预测的特征时间点严格早于标签时间点。
如何构建正确的时间序列验证框架?
为了避免上述陷阱,必须采用符合时间逻辑的验证策略。以下是两种常用的方法:
1. 简单时间切分(Hold-out Time Series Split)
这是最直观的方法。将数据集按时间排序,取最后N个时间段作为验证集,其余作为训练集。
| 步骤 | 操作描述 | 注意事项 |
|---|---|---|
| 排序 | 确保DataFrame按时间列升序排列 | 检查是否有重复时间戳或乱序数据 |
| 切分 | 选取最后20%的时间点作为验证集 | 不要打乱索引,保持原始顺序 |
| 训练 | 在前80%数据上拟合模型 | 确保没有使用任何未来统计量(如全局均值) |
| 评估 | 计算验证集指标 | 该分数更接近真实线上表现 |
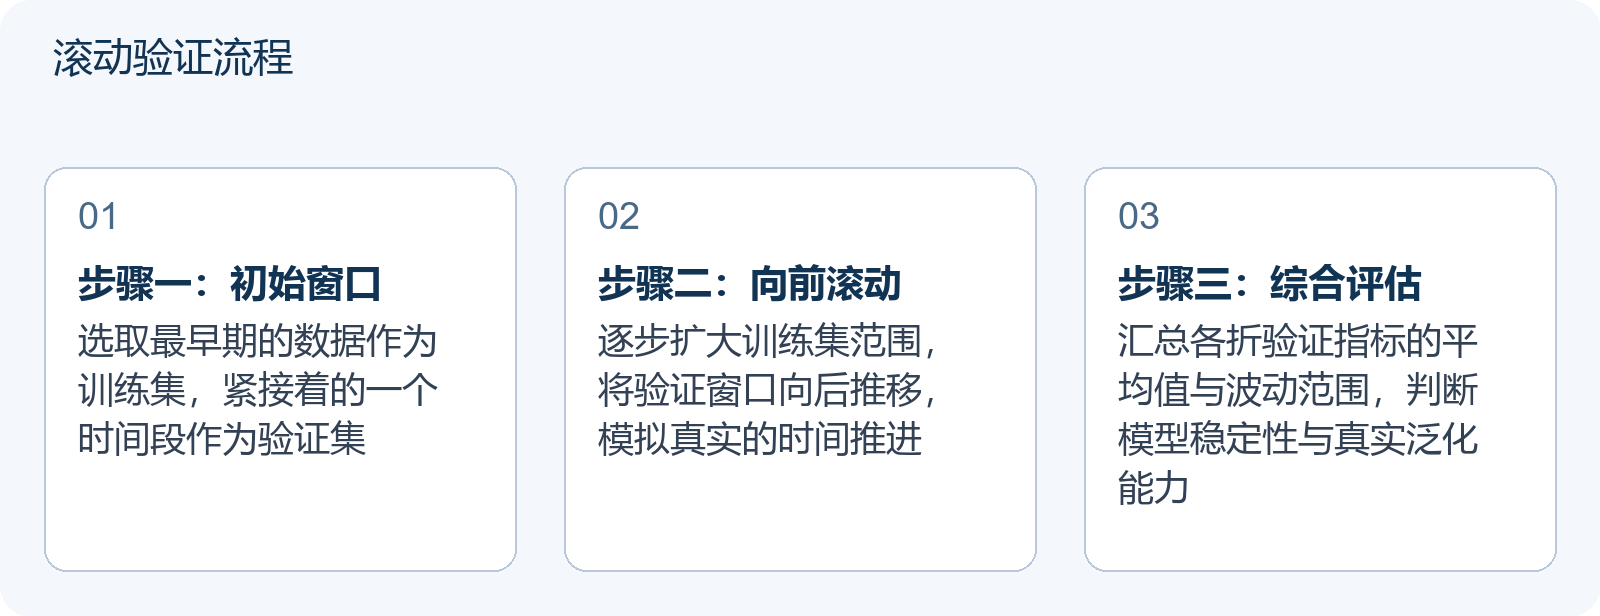
2. 滚动交叉验证(Rolling Origin Cross-Validation)
为了获得更稳健的估计,可以使用多个时间窗口进行验证。类似于 TimeSeriesSplit 类。
- Fold 1: Train [T1, T2], Validate [T3]
- Fold 2: Train [T1, T2, T3], Validate [T4]
- Fold 3: Train [T1, …, T4], Validate [T5]
这种方法能模拟模型在不同时间点的泛化能力,尤其适用于数据分布随时间漂移的场景。
常见误区与诊断清单
即使使用了时间切分,仍可能存在隐蔽的泄露。请对照以下清单自查:
- 特征工程泄露:是否在预处理阶段使用了全量数据的统计量(如StandardScaler的fit_transform)?
修正:仅在训练集上fit scaler,然后transform训练集和验证集。 - 目标编码泄露:是否对类别变量进行了目标编码(Target Encoding)且未考虑时间顺序?
修正:使用历史均值或平滑后的时间感知编码。 - 缺失值填充:是否使用了未来数据进行插值?
修正:使用前向填充(Forward Fill)或仅基于过去数据的插值。
下一步行动建议
对于准备参加Kaggle时间序列相关竞赛的同学,建议在 Notebook 中首先实现一个基于时间的 Baseline。不要急于尝试复杂的深度学习模型,先确保你的验证框架是诚实的。你可以参考我们之前的文章Kaggle Notebook 公开前该检查什么?从代码规范到学术诚信的七项自检(2026)来规范代码结构,或通过Kaggle 评分指标详解:Accuracy、Log Loss 与对数 RMSE 的三个算例了解不同评估指标的计算方式与适用场景。此外,Kaggle 注册:新手参赛前的账号、验证与规则准备清单(2026)提供了参赛前的基础准备清单,帮助你顺利开始第一场竞赛。
记住,一个好的本地验证分数应该是保守的。如果你的CV分数远高于LB(Leaderboard)分数,通常意味着验证集过于乐观;反之,如果CV分数远低于LB,则可能存在严重的欠拟合或特征处理不一致。
常见问题
所有Kaggle比赛都不能用随机切分吗?
不是。只有涉及时间序列、面板数据或具有明显时间依赖性的比赛才禁止随机切分。对于图像分类、自然语言处理(非对话流)或静态结构化数据,随机切分通常是标准的。
如果数据量很小,时间切分会导致训练集太少怎么办?
可以尝试使用留一法(Leave-One-Out)的时间变体,或者使用更短的验证窗口。另外,可以引入外部数据增强训练集,或使用迁移学习预训练模型以减少对大量历史数据的依赖。
Kaggle官方文档有规定必须用时间切分吗?
Kaggle官方通常不会强制规定具体的验证方法,但会在Evaluation页面说明指标。如果比赛要求预测未来时间段,那么逻辑上必须使用时间切分才能准确评估模型在该任务上的表现,否则本地分数无意义。