直接回答:当数据集中某一类样本极少时,模型即使完全预测为多数类也能获得极高的准确率,但这意味着它未能识别出真正关键的少数类信息。这种”虚假的高分”会误导参赛者认为模型有效,实则在实际应用中无法完成识别少数类的核心任务。
类别不平衡如何扭曲准确率的意义
类别不平衡(Class Imbalance)指分类任务中不同类别的样本数量差异悬殊。在欺诈检测、疾病诊断或工业缺陷识别等场景中,正常样本占绝大多数,异常样本仅占极小比例。此时,准确率(Accuracy)——即正确预测数占总样本数的比例——会失去判别力。因为模型只需将所有样本预测为多数类,即可获得极高的准确率,却完全丧失了识别少数类的能力。
这一现象被称为”准确率悖论”:在不平衡数据上,高准确率与模型实际价值可能完全脱钩。Kaggle竞赛中若评价指标设计不当,参赛者极易陷入这一陷阱。
教学演示:一个虚构的二分类案例
【教学演示:以下数据为虚构,用于说明原理】
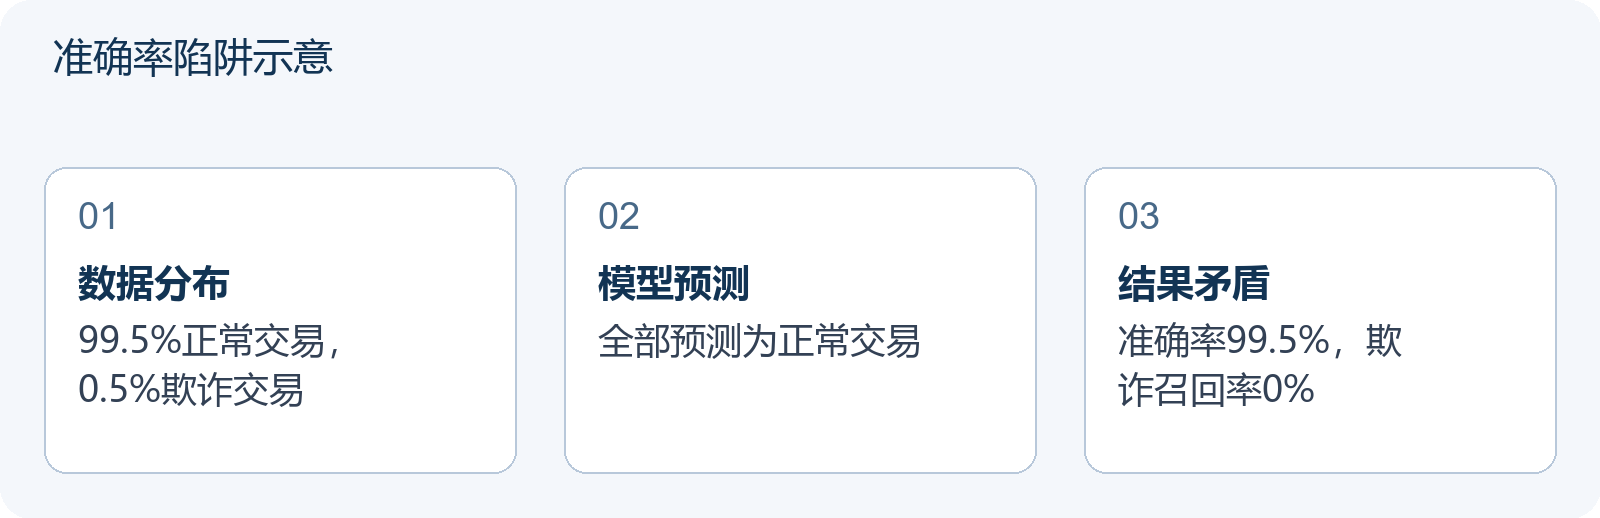
假设某信用卡欺诈检测数据集共10,000条记录:正常交易9,950条(标签0),欺诈交易50条(标签1)。
模型A:全预测为正常(0)
- 正确预测:9,950个
- 错误预测:50个(全部漏检)
- 准确率 = 9,950 ÷ 10,000 = 99.5%
- 欺诈类召回率 = 0 ÷ 50 = 0%
- 精确率(Precision):未定义(无预测阳性)
- F1分数(zero_division=0):0
模型B:识别出部分欺诈但有一定误报
假设模型B正确识别40个欺诈样本,同时误将200个正常样本判为欺诈。
- TP = 40,FP = 200,FN = 10
- 正确预测正常:9,950 − 200 = 9,750
- 正确预测欺诈:40
- 总正确:9,750 + 40 = 9,790
- 准确率 = 9,790 ÷ 10,000 = 97.9%
- 精确率 = 40 ÷ (40 + 200) = 40 ÷ 240 ≈ 16.67%
- 召回率 = 40 ÷ (40 + 10) = 40 ÷ 50 = 80%
- F1 = 2 × 40 ÷ (2 × 40 + 200 + 10) = 80 ÷ 290 ≈ 27.59%
关键对比:模型A准确率更高(99.5% > 97.9%),但完全无法发现欺诈;模型B准确率略低,却具备实际筛查价值。若仅看准确率,会错误判定模型A更优。但模型B的实际价值还取决于误报与漏报的成本——若每笔误报需人工复核200元、每笔漏报损失50,000元,则模型B的经济性需另行计算,不能仅凭召回率判优。
对比演示:同一准确率优化思路在医疗场景中的失败
【教学演示:以下数据为虚构,用于展示同一方法的失败】
假设某疾病筛查数据集共10,000例:健康者9,900例(标签0),患者100例(标签1)。某模型经过训练后输出概率,但参赛者仍以”最大化准确率”为目标选择分类阈值。
模型在0.5默认阈值下的表现:
- 预测为健康的:9,850例(含50例漏诊患者)
- 预测为患病的:150例(含50例真患者、100例误报健康者)
- 正确预测健康:9,900 − 100 = 9,800
- 正确预测患病:50
- 总正确:9,800 + 50 = 9,850
- 准确率 = 9,850 ÷ 10,000 = 98.5%
- 患者召回率 = 50 ÷ 100 = 50%(漏诊率50%,远超业务要求的5%上限)
此时参赛者认为模型已足够好。但业务要求”漏诊率不得超过5%”(即患者召回率≥95%)。若将阈值从0.5下调至0.2以捕获更多患者:
- 新增捕获患者:从50增至95(召回率95%)
- 新增误报健康者:从100增至500
- 正确预测健康:9,900 − 500 = 9,400
- 正确预测患病:95
- 总正确:9,400 + 95 = 9,495
- 准确率 = 9,495 ÷ 10,000 = 94.95%
关键对比:追求”最高准确率”会选择0.5阈值(98.5%),但这违反业务约束(漏诊率50% vs 要求5%);满足业务约束的0.2阈值反而使准确率”下降”至94.95%。这说明在不平衡数据中,准确率与关键业务目标可能直接矛盾:同一”优化准确率”的思路,在需要控制漏检率的场景中会系统性失败。
更合适的评估指标
针对类别不平衡,应补充以下指标:
- 精确率(Precision):预测为正类中实际为正类的比例,衡量”报得准不准”
- 召回率(Recall):实际正类中被正确预测的比例,衡量”找得全不全”
- F1分数:精确率与召回率的调和平均,综合衡量。竞赛须按实际Evaluation指标优化,不可默认F1为唯一目标
- AUC-ROC:ROC曲线下面积。在类条件分布不变时,ROC-AUC不受先验比例影响;但若类条件分布变化,AUC仍会变化
- AUC-PR:PR曲线下面积。在极端不平衡且关注精确率时更具区分力,但并非万能,需结合业务场景选择
上述案例中,模型A的F1分数为0(因召回率为0),模型B的F1分数约为27.59%。无论精确率如何,F1均显著优于模型A。
处理类别不平衡的四种策略
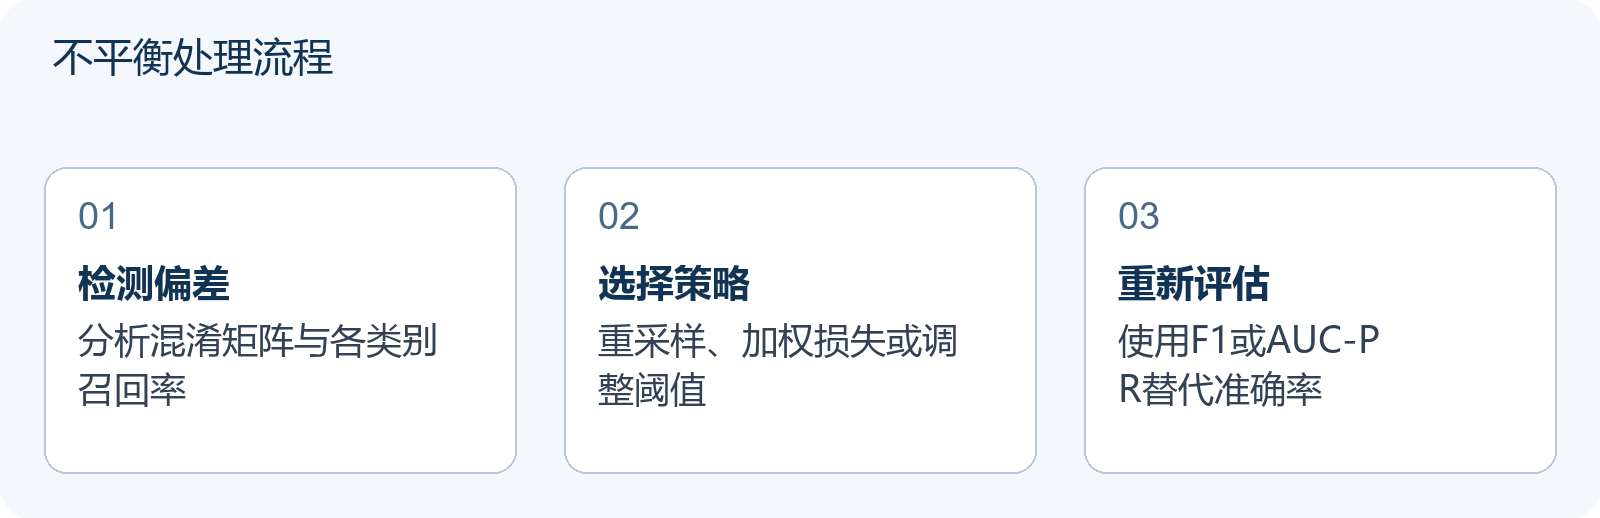
- 重采样:过采样(如SMOTE生成合成少数类样本)或欠采样减少多数类。关键原则:重采样仅在训练折内进行,验证集必须保持原始分布,防止数据泄露。
- 调整损失函数权重:为少数类错误分配更高惩罚,如加权交叉熵。XGBoost、LightGBM等框架的scale_pos_weight参数即此原理。
- 阈值调整:不默认使用0.5分类阈值,而是根据业务成本选择最优阈值。例如,若漏检欺诈的代价远高于误报,应降低阈值以提高召回率。
- 选用对不平衡鲁棒的算法:不同算法对不平衡的敏感度各异,需通过交叉验证实证比较,不可预设某类算法”天然”更优。
诊断应用:三步验证模型是否受困于不平衡
- 检查混淆矩阵:关注假阴性(False Negatives)数量。若少数类大量漏检,即使准确率高也说明问题。
- 对比类别召回率:计算每个类别的独立召回率。若少数类召回率显著低于多数类,模型存在偏向性。
- 绘制PR曲线并计算AUC-PR:相比ROC曲线,PR曲线在不平衡数据中更能反映模型区分能力。若AUC-PR接近正例比例基线,说明模型未学到有效模式。
下一步行动
确认存在类别不平衡问题后,应停止优化准确率,转而以比赛指定的Evaluation指标为目标(可能是F1、AUC或其他加权指标),业务场景则需另行做成本分析。在Kaggle竞赛中,务必仔细阅读Evaluation页面的指标说明——部分比赛直接使用F1、AUC或加权指标,此时准确率仅具参考意义。理解指标背后的数学含义,比盲目刷分更能提升竞赛表现与模型质量。
相关深入阅读:Kaggle 评分指标详解:Accuracy、Log Loss 与对数 RMSE 的三个算例、Kaggle时间序列验证:随机切分为什么可能高估模型效果、Kaggle特征消融实验:怎样判断新增特征是真的有用。
常见问题
为什么我的模型准确率很高但在比赛中排名靠后?
Kaggle竞赛通常使用F1、AUC-PR或对数损失等指标,而非原始准确率。若你的模型过度拟合多数类、忽略少数类,即使准确率高,在这些指标上也会表现不佳。请检查比赛Evaluation页面的具体评分标准,按实际指标优化。
SMOTE过采样总是有效的吗?
不一定。SMOTE在特征空间稀疏或噪声较多的区域可能生成无意义的合成样本,反而引入干扰。建议配合交叉验证评估效果,并考虑Borderline-SMOTE等改进变体。关键是过采样仅在训练折内进行,验证集保持原始分布。
如何确定应该优化精确率还是召回率?
取决于业务场景中的错误成本。漏检代价高(如疾病筛查、欺诈检测)时优先召回率;误报代价高(如垃圾邮件过滤、广告推荐)时优先精确率。Kaggle比赛中若无明确说明,通常按Evaluation指标优化;业务场景需做成本分析,不可仅凭直觉。