直接回答:先看四件事,而不是看比赛名字
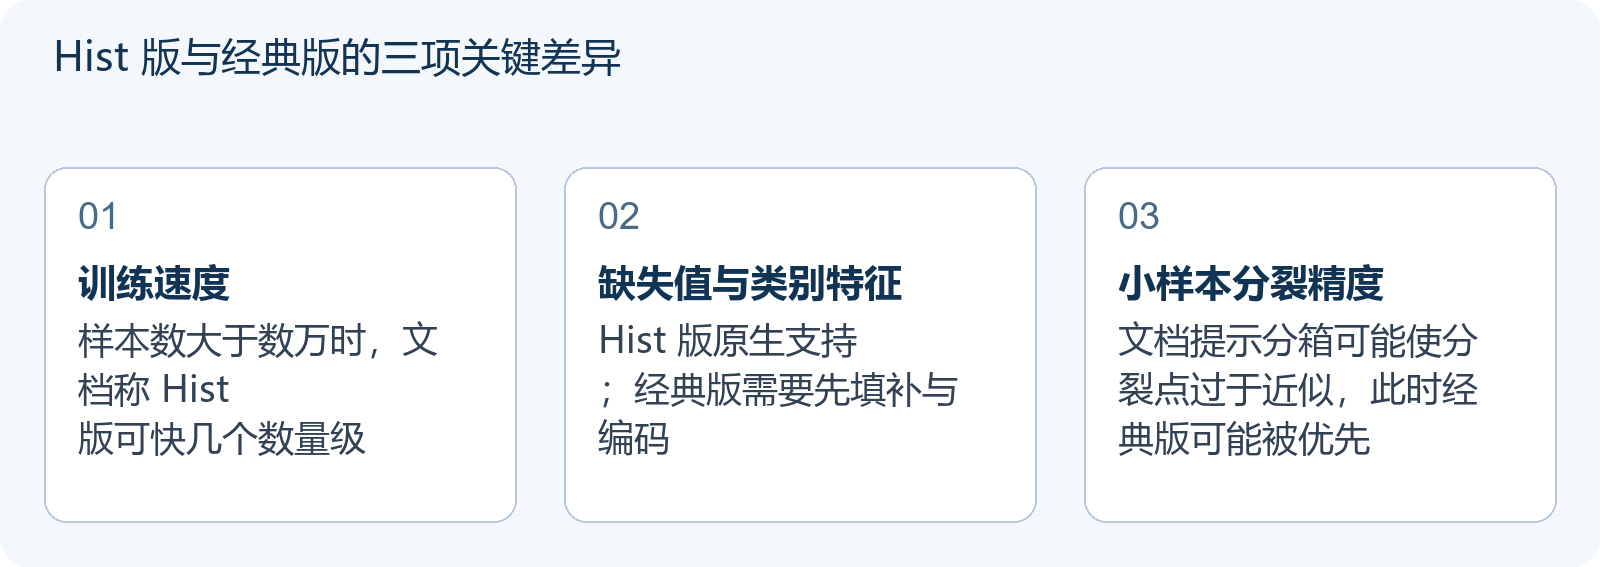
在 Kaggle 表格赛模型选择这件事上,可执行的判断顺序只有四步:样本量、缺失值情况、类别特征的基数、以及你需要哪种损失函数。scikit-learn 官方文档「1.11. Ensembles」(stable 文档,站点标注版本 1.9.1,检索时间 2026-10-26)写明:当样本数大于数万时,直方图版的 HistGradientBoosting 可以比经典 GradientBoosting 快几个数量级;缺失值与类别数据由 Hist 版原生支持,省去填补与编码;同时文档也写明,小样本场景下经典版可能被优先,因为直方图分箱可能让分裂点过于近似。
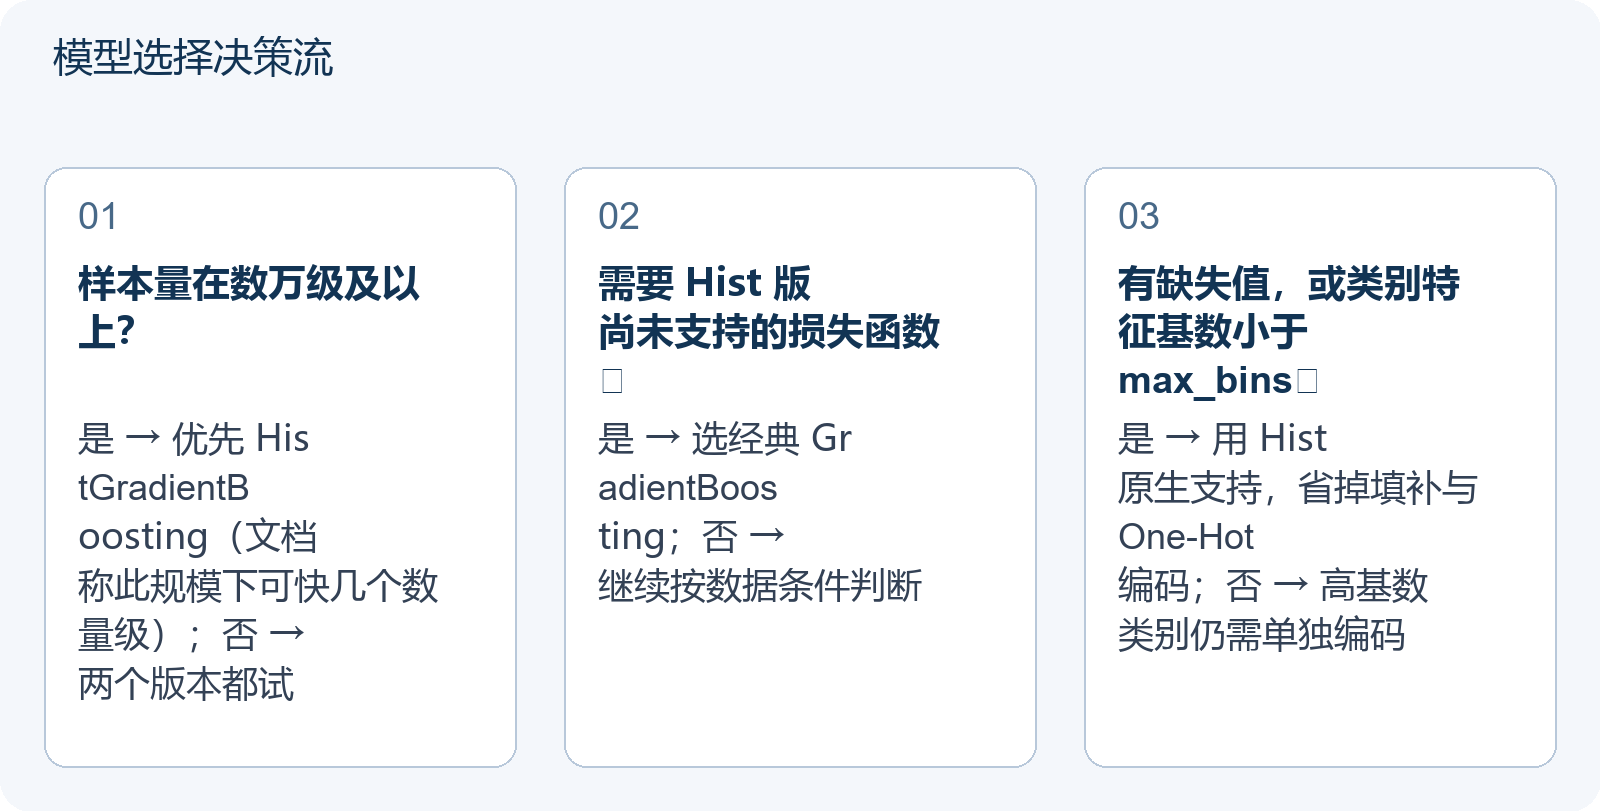
据此可以给出一句可直接执行的结论:数万行及以上,先跑 Hist 版,并把缺失值和类别列交给它原生处理;几千行以内,两个版本都跑一遍再比较交叉验证;如果你的训练目标需要 Hist 版尚未支持的损失函数,就先跑经典版。下面把每一步拆开,并给出一个标注为教学假设的算例。
第一步:任务是哪一类,类别数多不多
经典 GradientBoostingClassifier 与 HistGradientBoostingClassifier 都支持二分类和多分类,回归也各有一个对应类,所以“能不能用”通常不是问题。真正的差别在多分类的开销:文档说明,超过两个类别的分类需要在每一轮迭代中为每个类别各建一棵回归树,总树数约为 n_classes × n_estimators;对于类别数较多的数据集,文档明确建议改用 HistGradientBoostingClassifier。所以第一步要问的不是“哪个模型更强”,而是“我的类别数量会不会让经典版的训练量成倍膨胀”。
第二步:样本量落在哪个区间
这是选择的主要分界线,但要说清楚文档承诺了什么、没有承诺什么。
- 文档明确写的:样本数大于数万时,Hist 版可以快几个数量级。这是速度结论,不是精度结论。
- 文档明确写的:小样本下经典版可能被优先,原因是分箱可能使分裂点过于近似。
- 属于实操建议、不是文档保证的:把 1 万行左右当作“开始明显受益于 Hist”的起点,把几千行以内当作“两个都要试”的区间。这只是把文档的定性表述落到可操作门槛上,具体到你的数据仍要实测。
- 容易忽略的默认行为:Hist 版在训练样本数大于 10,000 时会默认启用 early stopping。如果你不显式设置,
max_iter很可能不会跑满,于是两个版本的“轮数”并不等价,比较时容易得出错误结论。
第三步:缺失值与类别特征怎么处理
Hist 版对缺失值(NaN)是原生支持的:训练时树会在每个分裂点学习缺失样本应进左子树还是右子树;如果某个特征在训练中从未出现缺失值,预测阶段的缺失样本会被分到样本较多的那个子节点。这意味着你不必先写一遍中位数或众数填补,也就少了一处可能引入偏差的预处理步骤。
类别特征同样是原生支持:通过 categorical_features 参数指定哪些列是类别型(布尔掩码、列索引或 DataFrame 列名都可以)。文档解释这通常优于 One-Hot 编码,因为 One-Hot 需要更深的树才能达到等效分裂;也不应把类别当作有序数值来处理。
但这里有一个必须写进决策的限制:文档要求每个类别特征的基数必须小于 max_bins,而 max_bins 的默认值是 255。所以像用户 ID、商品 SKU 这类基数为几千甚至几十万的列,并不能指望“原生类别支持”免费解决——它们仍然属于需要单独设计编码方式并配合验证的高基数特征。另外,预测阶段出现训练时未见过的类别,会被当作缺失值处理,这也是线上表现与本地验证不一致时的常见来源之一。
第四步:损失函数的支持范围不一样
文档写明,Hist 版分类器只提供 log_loss 一种损失;回归可选 squared_error(默认)、absolute_error、gamma、poisson 和 quantile、gamma。文档同时指出,Hist 版尚未支持经典版的全部功能,“例如某些损失函数”。因此,如果你的训练目标必须落在经典版才有、Hist 版尚未支持的那一类上,就直接选经典版;不要为了速度去改训练目标。
还要区分两件事:训练用的损失函数由库定义,排行榜的评分指标由比赛主办方定义,两者经常不一致。例如用 log_loss 训练分类模型、排行榜却按 AUC 或 F1 排名,这是正常情况——你仍然训练在 log_loss 上,再用阈值选择或后处理去对齐指标。这正是“库文档不等于 Kaggle 评分规则”的具体含义。
教学假设算例:8 万行、12 个类别特征、15% 缺失值
以下为教学假设示例,不是任何真实比赛的数据,也不构成成绩预测。假设你拿到一份 80,000 行、含 12 个类别特征、约 15% 缺失值的表格数据,任务是二分类:
- 先定基线:用 Hist 版默认参数跑一次,缺失值原样交给模型,把 12 个类别列填进
categorical_features,记录交叉验证分数与训练耗时。 - 再做对照:用经典版跑同一批特征,缺失值需要你自己填补、类别列需要编码,同样记录耗时与分数。这一步回答的是一个具体问题:在这份数据上,两个版本的速度差和精度差各有多大。具体倍数取决于特征数、树的大小和机器,应以你环境中的实测为准,不要套用别人的数字。
- 然后决定下一步:如果两版分数接近,就用更快的那一个继续做特征工程;如果经典版明显更好,再检查是否由分箱精度或早停默认值造成差异,而不是直接放弃 Hist 版。
一个可以直接改的教学代码骨架:
from sklearn.ensemble import HistGradientBoostingClassifier

# 教学示例:X 为 pandas DataFrame
clf = HistGradientBoostingClassifier(
    categorical_features=["city", "device", "channel"],  # 示意:实际把 12 个类别列全部填进来
    max_iter=300,        # 对应经典版的 n_estimators
    learning_rate=0.06,
    max_bins=255,        # 默认值
    early_stopping=True,  # 样本数大于 10,000 时默认即为 True
)
clf.fit(X_train, y_train)这段骨架只是示意参数位置:max_iter 取代了经典版的 n_estimators,把经典版的参数名原样复制过来会直接报错。
经典版仍可能先跑的三个场景
- 样本量小:文档提示分箱可能让分裂点过于近似,此时经典版的精确分裂值得一试。
- 需要 Hist 版尚未支持的损失函数:以文档列出的可用损失为准,逐项核对你的训练目标。
- 需要在一份已拟合模型上继续加树:文档在经典版一节写明
warm_start=True可以在已拟合模型上继续增加弱学习器,适合“先跑一批看方向、再续着加”的调试节奏。
实操检查表
| 检查项 | 建议动作 | 依据或原因 |
|---|---|---|
| 样本量 | 数万行及以上优先 Hist;几千行以内两个都跑 | 文档的速度结论是“数万以上快几个数量级”;小样本的精度差异属于需要实测的开放项 |
| 缺失值 | 先让 Hist 原生处理,不必先填补 | 文档:原生支持 NaN,避免额外的填补步骤 |
| 类别特征 | 基数小于 max_bins(默认 255)的列用 categorical_features;基数更高时另做编码 | 文档:每个类别特征的基数必须小于 max_bins;未见类别在预测时按缺失值处理 |
| 多分类且类别较多 | 直接偏 Hist 版 | 文档:类别数较多时建议使用 HistGradientBoostingClassifier |
| 早停与迭代预算 | 比较两版前先统一早停设置与轮数口径 | 文档:Hist 版在样本数大于 10,000 时默认启用早停 |
| 验证方式 | 与模型选择分开处理:分组结构用分组切分,时序结构用时序切分 | 在分组或时序数据上,随机切分通常会高估效果,这是独立于模型版本的错误 |
把比较记录下来,这次选择才有意义
两个版本跑完之后,如果不记录配置与结果,这次比较等于白做。至少要留下四列:版本与主要参数、训练耗时、交叉验证分数,以及验证方案本身。站内这篇 Kaggle实验管理:让特征、参数与验证结果能够一一对应 讲的是如何把每轮变化落到可复现的记录里,可以直接套用。
如果你还在犹豫某个特征是否值得保留,可以先做一次 Kaggle特征消融实验:怎样判断新增特征是真的有用,再决定要不要把它带进最终配置。基模型选择和特征取舍是两个独立问题,不要混在同一次实验里同时改。
等你手里有两个以上稳定模型,再考虑要不要融合。站内 Kaggle模型集成:先检查错误是否互补,再决定要不要融合 给出的顺序是“先看错误是否互补”,这比默认把 Hist 版与经典版简单平均更有依据。
基模型选择本身不直接决定成绩,它决定的是你能多快开始做真正影响分数的实验。把版本、参数、耗时与验证方案记录清楚,再进入下一轮特征工作,这次比较才算真正有价值。
一般活动背景信息可参见scikit-learn 集成学习文档。
这是一份独立的备考指南,与 Kaggle 或其赛事主办方 无隶属、认可或赞助关系。
常见问题
HistGradientBoosting 更快,是否一定意味着分数更高?
不一定。文档给出的“快几个数量级”是速度结论,出现在样本数大于数万的场景;在小样本上,文档提示分箱可能让分裂点过于近似,经典版此时可能被优先。速度影响的是你能迭代多少轮,而不是模型上限。稳妥做法是同一份特征、同一套验证下把两个版本各跑一次,用记录下来的耗时和分数决定。
为什么不能把 scikit-learn 文档当作 Kaggle 的官方评分规则?
两者管辖范围不同。scikit-learn 文档描述的是库能训练哪些损失函数、默认行为是什么;Kaggle 比赛的评分指标由主办方在比赛页的 Evaluation 一栏定义,可能按 AUC、F1 或自定义公式排名。你通常仍用 log_loss 之类可训练的损失去拟合模型,再用阈值选择或后处理去对齐排行榜指标。选型要符合库的能力,目标要对齐比赛的评分标准。
类别特征很多,直接写进 categorical_features 就够了吗?
不够。文档要求每个类别特征的基数必须小于 max_bins,而 max_bins 默认是 255。基数在几百以上的列(例如用户 ID、商品编号)仍需单独设计编码方式并配合验证,不能依赖原生支持。此外,预测阶段出现训练时未见过的类别会被当作缺失值处理,这也是本地与线上表现不一致时的常见来源。