在 Kaggle 竞赛中,模型集成(Ensemble)常被视为提分的“终极武器”。许多新手在训练出几个不错的单模型后,会本能地将它们简单平均或加权融合,期望获得更高的分数。然而,实际结果往往令人失望:集成后的分数不仅没有提升,反而低于表现最好的那个单模型。这并非因为集成方法本身无效,而是因为忽略了集成的核心前提——模型之间的错误必须是互补的。
如果两个模型在相同的样本上犯相同的错误,或者它们的错误高度相关,那么将它们融合只会稀释信号,甚至引入噪声。真正的有效集成,要求模型具备“多样性”:即一个模型看错的样本,另一个模型能看对。因此,在决定要不要融合之前,必须先检查错误分布。本文将通过具体的教学演示案例,说明如何量化这种互补性,并给出实用的诊断步骤。
为什么简单的平均可能失效?
假设我们有两个模型 A 和 B,它们在验证集上的准确率都是 80%。直觉告诉我们,如果我们将两者的预测概率取平均值,准确率应该能达到 90% 左右。但这个直觉只有在模型错误完全独立时才成立。
让我们构建一个极端但常见的情况:模型 A 和模型 B 实际上使用了非常相似的特征工程逻辑,或者都依赖于数据中的同一个强信号(例如某个特定的 ID 编码)。在这种情况下,当模型 A 因为缺乏关键信息而预测错误时,模型 B 很可能也因为同样的原因预测错误。此时,两者的错误是正相关的。融合这两个模型,相当于把同一个错误的声音放大了两倍,而不是引入了新的视角。结果就是,集成模型的准确率依然停留在 80%,甚至因为数值不稳定而略微下降。
相反,如果模型 A 擅长捕捉线性关系,而模型 B 擅长捕捉非线性交互特征,那么当 A 因为无法处理复杂交互而犯错时,B 可能恰好能纠正它。这种低相关性或部分互补的错误分布,才是集成带来增益的来源。需要注意的是,错误低相关即可带来收益,并非必须负相关;且模型算法不同并不保证误差独立。
教学案例一:互补性带来的真实增益
注:以下数据为虚构的教学演示,旨在说明原理,非真实比赛数据或官方评分标准。
考虑一个二分类问题,验证集共有 100 个样本。我们需要判断两个模型是否值得融合。
- 模型 X:基于梯度提升树(GBDT),擅长处理结构化表格特征。
- 模型 Y:基于神经网络,擅长从文本描述中提取语义特征。
我们统计每个样本上两个模型的预测正确与否:
| 状态组合 | 样本数量 | 占比 | 含义 |
|---|---|---|---|
| X 对, Y 对 | 60 | 60% | 共识区,两者都自信且正确 |
| X 错, Y 错 | 10 | 10% | 困难样本,两者都无法解决 |
| X 对, Y 错 | 20 | 20% | X 的优势区,Y 在此处失败 |
| X 错, Y 对 | 10 | 10% | Y 的优势区,X 在此处失败 |
单独来看,模型 X 的准确率是 (60+20)/100 = 80%。模型 Y 的准确率是 (60+10)/100 = 70%。
这里的关键观察是:存在 30 个样本(20+10)是两个模型意见不一致的。在这些分歧点上,X 和 Y 各有优势区域。如果我们能利用这种互补性,集成有望将原本被单个模型错误分类的部分样本转化为正确分类。
但需要注意一个关键限制:在平局时我们无法预先知道哪个模型正确。假设我们采用简单的多数投票(硬投票,Hard Voting),对于“X 对, Y 错”和“X 错, Y 对”这 30 个样本,投票结果是平局。如果我们固定选择 X(即总是相信 X),则集成正确数为 60 + 20 = 80,准确率仍为 80%,与 X 单独表现相同。如果采用公平的随机平局打破(如抛硬币),期望正确数为 60 + 20×0.5 + 10×0.5 = 75,准确率降至 75%。
这个案例说明:互补性的存在是必要条件,但不足以自动保证集成提升。真正的增益需要更智能的融合策略,而非简单投票。理想情况下,若能预知哪个模型在特定样本上更可靠(oracle),上限可达 90%,但这在实际中不可实现。
教学案例二:相关性导致的集成陷阱——融合反而浪费算力
注:以下数据同样为虚构的教学演示,非真实比赛数据。
现在考虑另一种情况。模型 P 和模型 Q 都是基于随机森林,但使用了不同的超参数(如 max_depth 不同)。表面上看,它们是“不同”的模型。
验证集同样有 100 个样本:
| 状态组合 | 样本数量 | 占比 | 含义 |
|---|---|---|---|
| P 对, Q 对 | 75 | 75% | 高度共识 |
| P 错, Q 错 | 15 | 15% | 共同盲区 |
| P 对, Q 错 | 5 | 5% | 极少分歧 |
| P 错, Q 对 | 5 | 5% | 极少分歧 |
模型 P 准确率 (75+5)/100 = 80%,模型 Q 准确率 (75+5)/100 = 80%。
采用公平随机平局打破分析:75 个共同正确 + 15 个共同错误 + 10 个分歧点各 50% 正确率 = 75 + 10×0.5 = 80 个正确,准确率 80%。即使假设存在神奇的 oracle 能在平局中总是选对,上限也只有 75 + 10 = 85 个正确,即 85%——但这在实际投票中无法实现。
更本质的问题是软投票(概率平均)。考虑一个具体可验证的例子:真实标签 y = [1, 0, 1, 0],模型 A 输出概率 [.9, .6, .4, .1],模型 B 输出 [.6, .2, .8, .4]。平均概率为 [.75, .4, .6, .25],按 0.5 阈值分类,四个样本分别判为 1, 0, 1, 0,与真实标签一致。但单独看:A 的预测为 1,1,0,0(正确率 50%),B 的预测为 1,0,1,0(正确率 100%)。这个例子说明:概率平均可以改变决策,但需要实际重算验证,不保证提升。在案例二的高相关性场景下,P 和 Q 的概率估计高度相关,在“P 错, Q 错”的 15 个样本上,两者都给出错误方向的高置信度,平均后依然错误;在分歧样本上,概率平均可能使结果趋于 0.5 附近,反而降低置信度。
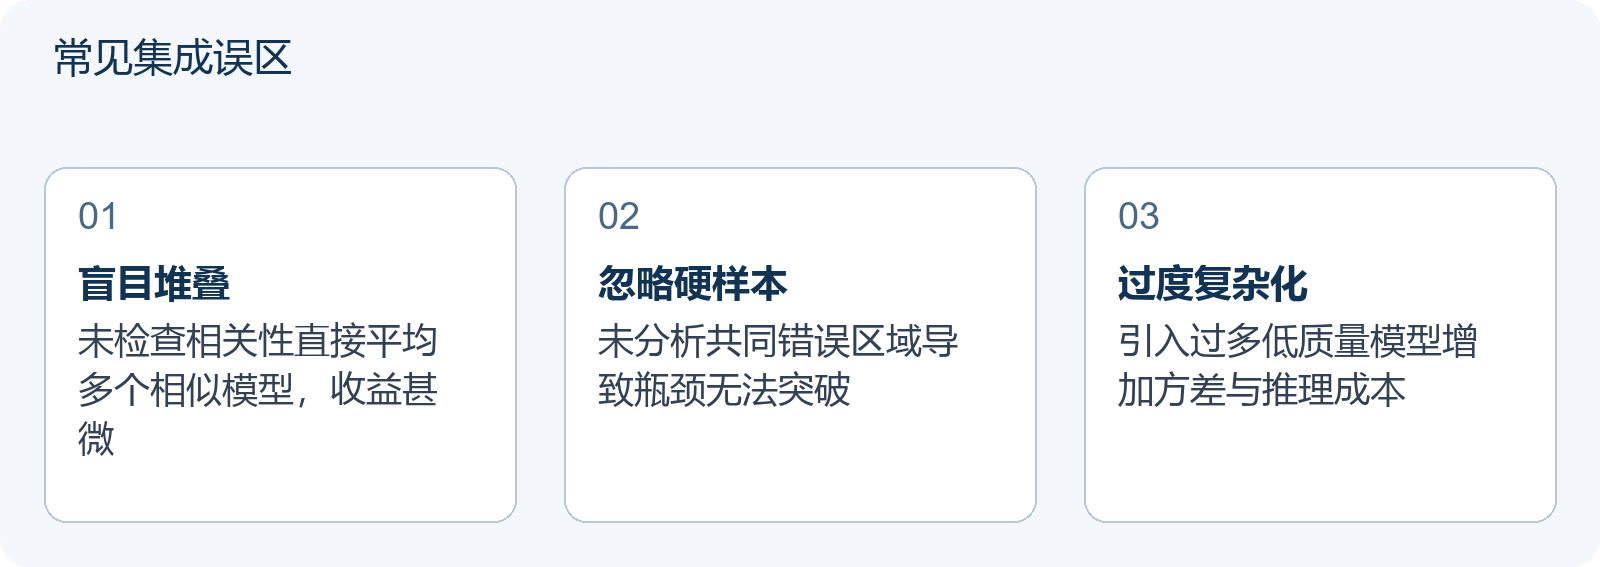
这就是典型的集成陷阱:你花费了双倍的训练时间、双倍的模型存储、双倍的推理成本,却只获得了微乎其微甚至不稳定的提升。当模型数量继续增加时,边际收益迅速递减。虽然代码不同,但学到的模式本质相同,正相关虽小于 1 仍难以突破瓶颈——融合在这里不是错误,但几乎是一种浪费。
如何量化错误互补性?
要科学地决定是否集成,不能仅凭感觉,需要计算指标。最实用的是观察联合错误矩阵和分歧率。
对于分类问题,统计以下四个值:
- N_11: 模型 A 和 B 都预测正确的数量
- N_00: 模型 A 和 B 都预测错误的数量
- N_10: A 对 B 错的数量
- N_01: A 错 B 对的数量
有效的集成通常希望 N_10 和 N_01 较大且相对均衡(说明各有优势领域),同时 N_00 较小。如果 N_00 很大,说明存在大量两个模型都无法解决的“硬骨头”,此时集成难以突破,需要回到特征工程或数据层面。
另一个快速指标是分歧率:(N_10 + N_01) / 总样本数。如案例一的分歧率为 30%,存在互补潜力;案例二的分歧率仅 10%,收益空间受限。分歧率需要结合单模型基线综合判断:若分歧率低且单模型本身已接近天花板,集成意义有限。
对于回归问题,可以绘制两个模型预测残差的散点图。如果点云呈对角线分布(正相关),说明错误模式相似,集成收益低;如果点云无明显趋势或呈反向趋势,则集成潜力大。正相关小于 1 时,集成仍可能降低方差,但收益递减。
实操建议:三步诊断法
在提交集成方案前,请执行以下步骤:
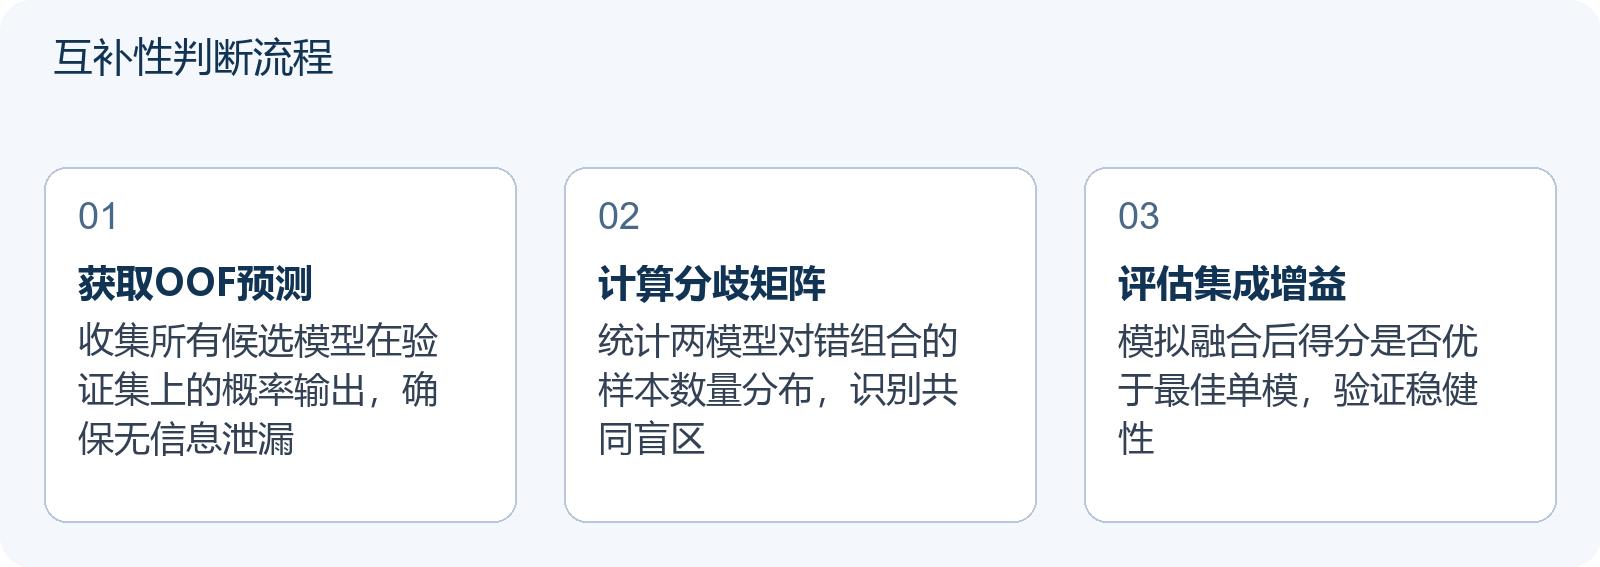
- 生成 OOF 预测:确保所有候选模型都在同一份验证集(或交叉验证的 Out-of-Fold 预测)上生成了概率输出。这是后续分析的唯一可信基础。权重和子群选择应仅在训练验证内部进行,最终评估必须在完全独立的测试集上完成,防止信息泄漏。
- 计算联合错误矩阵与分歧率:统计 N_11, N_00, N_10, N_01 四个值,计算分歧率。若分歧率较低且单模型性能已接近瓶颈,需警惕模型同质性。建议将集成效果与最佳单模型基线对比,而非追求绝对提升。
- 模拟集成效果:不要直接上传。先在本地用简单的平均或加权平均合并这些 OOF 预测,重新计算验证集得分。如果得分没有显著超过最佳单模型,则放弃该组合。注意验证提升是否稳健,而非单次随机波动。
此外,尝试分层集成。有时全局集成效果不好,是因为某些子群体(如特定类别或时间段)中模型表现差异巨大。你可以针对这些子群体分别选择最优模型,而不是强行统一融合。但子群选择同样需要在验证集内完成,不可事后在测试集上挑选。
何时应该停止集成?
集成不是越多越好。随着模型数量增加,边际收益递减,而复杂度急剧上升。当你发现新加入的模型与现有集成体的相关性极高,或者其单独性能远低于当前最佳模型时,应果断剔除。
记住,Kaggle 排行榜上的高分往往来自于对数据的深刻理解,而非单纯的算法堆砌。如果你的模型都在犯同样的错误,说明你对问题的理解可能存在盲区。此时,与其花时间调参做集成,不如回头检查特征工程和数据清洗环节。
关于如何选择第一场比赛以及新手入门的系统路径,可以参考 Kaggle 怎么入门?从零基础到第一次「有效提交」的 12 周路径(2026)。对于验证策略的深入理解,Kaggle分组交叉验证:同一用户出现在训练集和验证集怎么办 提供了关键的操作指南。若需理解评分指标对集成策略的影响,Kaggle 评分指标详解:Accuracy、Log Loss 与对数 RMSE 的三个算例 能帮助你选择更合适的融合方式。关于代码规范与可复现性,Kaggle Notebook 公开前该检查什么?从代码规范到学术诚信的七项自检(2026) 值得在集成前对照检查。
常见问题
如果两个模型准确率一样,是不是集成一定更好?
不一定。如果两个模型在相同的样本上犯错(错误高度相关),集成后的准确率不会提升,甚至可能因数值误差而下降。案例二显示,两个 80% 的模型集成后公平随机仅 80%,且软投票可能无增益。只有当错误低相关且存在互补区域时,集成才有效。
如何快速判断模型是否太相似?
查看预测标签的不一致率。如果两个模型在验证集上的预测结果有 95% 以上是一致的,说明它们太相似,集成带来的边际收益极低,不建议融合。同时观察联合错误矩阵中的 N_00(共同错误)是否过大。分歧率低时,建议对比单模型基线性能再做决定。
Stacking 和 Blending 有什么区别?
Blending 通常指在保留部分数据作为验证集上进行简单加权平均或线性组合;Stacking 则是训练一个元模型(Meta-Model)来学习如何组合基础模型的输出。Stacking 更灵活但更容易过拟合,需严格交叉验证。两者都需要通过 OOF 预测验证互补性,且最终评估必须在独立测试集上进行。