直接回答:Kaggle 类别特征编码怎么选
如果你在 Kaggle 表格赛中使用 scikit-learn 的 HistGradientBoostingClassifier 或 HistGradientBoostingRegressor,可以先按下面三步判断:
- 低基数类别:优先尝试原生
categorical_features支持。scikit-learn 1.9.1 官方文档《1.11. Ensembles》指出,对类别特征使用原生支持通常优于 one-hot,因为 one-hot 需要更深的树才能达到等价分裂,也比把类别当成连续有序值更合适。 - 高基数类别:如果某个类别特征的基数达到或超过
max_bins,不能直接依赖原生支持。文档明确要求每个类别特征的基数必须小于max_bins。默认max_bins为 255,文档也推荐尽量使用多的 bins(默认 255)。 - 预测时遇到未见类别:文档说明,预测时训练中未出现的类别会被当作缺失值处理。评估时要把新类别比例单独列出来。
因此,问题不是“原生 categorical 和 one-hot 哪个永远更好”,而是“当前特征的基数、缺失情况和新类别风险,允许你走哪条编码路线”。
scikit-learn 文档为什么认为原生 categorical 常优于 one-hot
许多初学者习惯对所有类别变量做 one-hot。它在类别很少时直观、稳定,也能配合线性模型或某些树模型使用。但在基于直方图的梯度提升树中,one-hot 会带来两个现实问题。
第一,one-hot 将每个类别展开为独立列。类别一多,特征维度迅速膨胀,树需要更多层才能组合出等价于“直接按类别集合分裂”的效果。scikit-learn 文档明确写道,对类别特征使用原生支持通常优于 one-hot,因为 one-hot 需要更多树深度才能达到等价分裂。
第二,类别通常是无序的名义变量。把“北京、上海、广州”编码成 1、2、3 会制造虚假的顺序。文档也指出,原生支持通常优于把类别特征当作连续有序值处理。
原生 categorical 支持允许算法直接在类别集合上寻找分裂。文档在“Split finding with categorical features”一节解释,梯度提升树本质上始终是回归树,因此可以先用目标变量的方差对类别排序,再考虑连续划分,从而避免穷举所有 2^(K-1)-1 种划分。这样复杂度从指数级降到 O(K log K + K)。这并不保证每个数据集都赢,但它解释了为什么低基数类别值得优先比较原生支持。
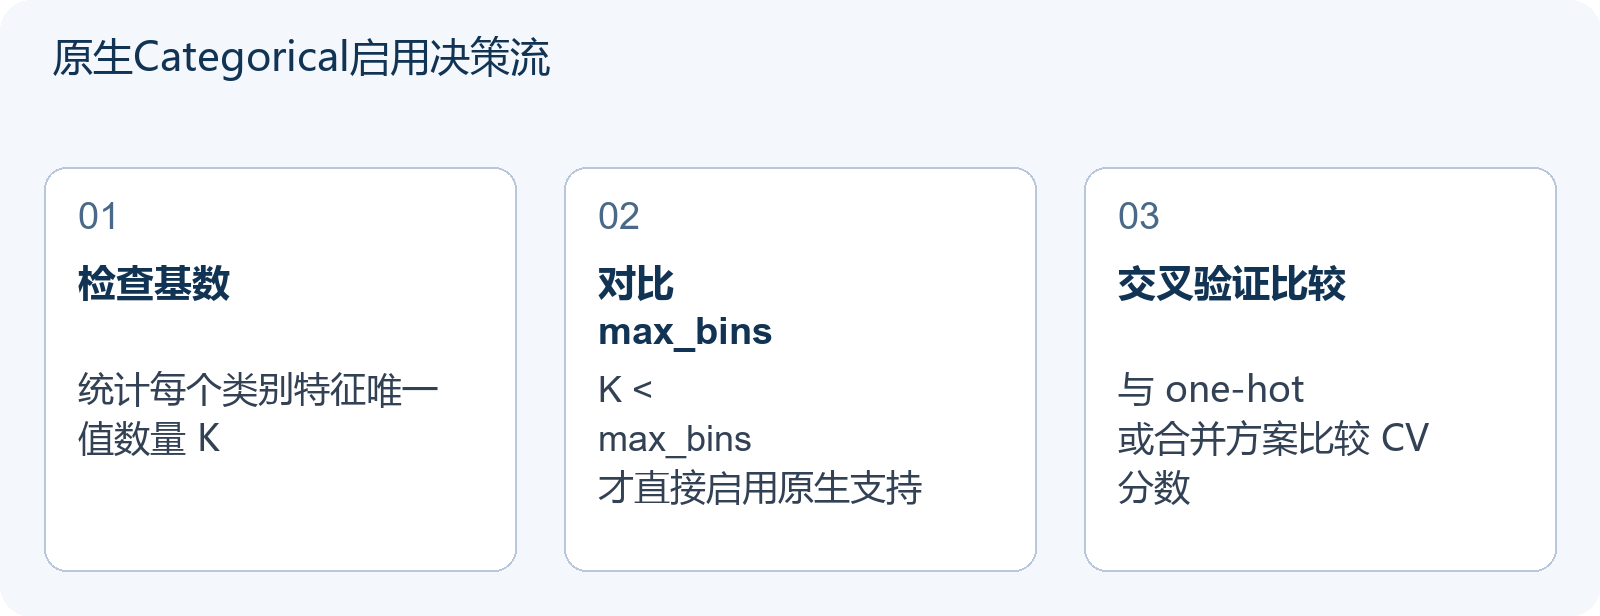
硬条件:每个类别特征基数必须小于 max_bins
max_bins 控制直方图分箱数量。文档要求:每个类别特征的基数必须小于 max_bins 参数。默认 max_bins 是 255,并且文档建议尽量使用多的 bins,也就是默认值 255。注意“小于”是严格小于,所以某个类别特征如果正好有 255 个类别,也不满足直接启用原生支持的文档条件。
下面是一个教学示例表,用于说明判断逻辑,不是真实 Kaggle 赛题配置:
| 场景 | 类别基数 K | max_bins | 能否直接启用原生支持 | 建议动作 |
|---|---|---|---|---|
| 二元状态 | 2 | 255 | 可以,2 < 255 | 直接启用 categorical_features |
| 城市名称 | 100 | 255 | 可以,100 < 255 | 直接启用,并与 one-hot 做对照实验 |
| 邮政编码前缀 | 400 | 255 | 不可以,400 不小于 255 | 先合并稀有类别,或改用其他编码路线 |
| 用户 ID | 10,000+ | 255 | 不可以,10,000+ 不小于 255 | 通常不应直接使用;考虑聚合、目标编码或移除 |
这里的重点不是“400 会报什么错”,而是它不满足文档要求。你不能在同一个类别特征上直接依赖原生 categorical 支持。是否调大 max_bins 属于实现层选择,但它不能替代对高基数特征本身的信息密度、新类别风险和验证效果的判断。
未见类别:预测时按缺失值处理
Kaggle 比赛常见训练集与测试集分布不一致,尤其是时间序列、新用户、新商品场景。scikit-learn 文档说明:预测时,训练中未出现的类别会被当作缺失值处理。
文档对缺失值还有更细的规则:如果训练时存在缺失值,缺失值会被当作一个正式类别;如果训练时没有缺失值,预测时的缺失值会被送到样本数最多的子节点。因此,未见类别走的是缺失值处理路径,但实际去向取决于训练时是否存在缺失值以及树在该特征上学到的分裂。
实践上,建议在交叉验证阶段专门统计“验证集中包含训练未见类别的样本比例”。如果这个比例很低,原生支持通常可以接受;如果比例很高,模型对这些样本的区分能力可能下降,此时频率合并、目标编码或显式把稀有类别归入“Other”往往更稳。
高基数类别的三条备选路线
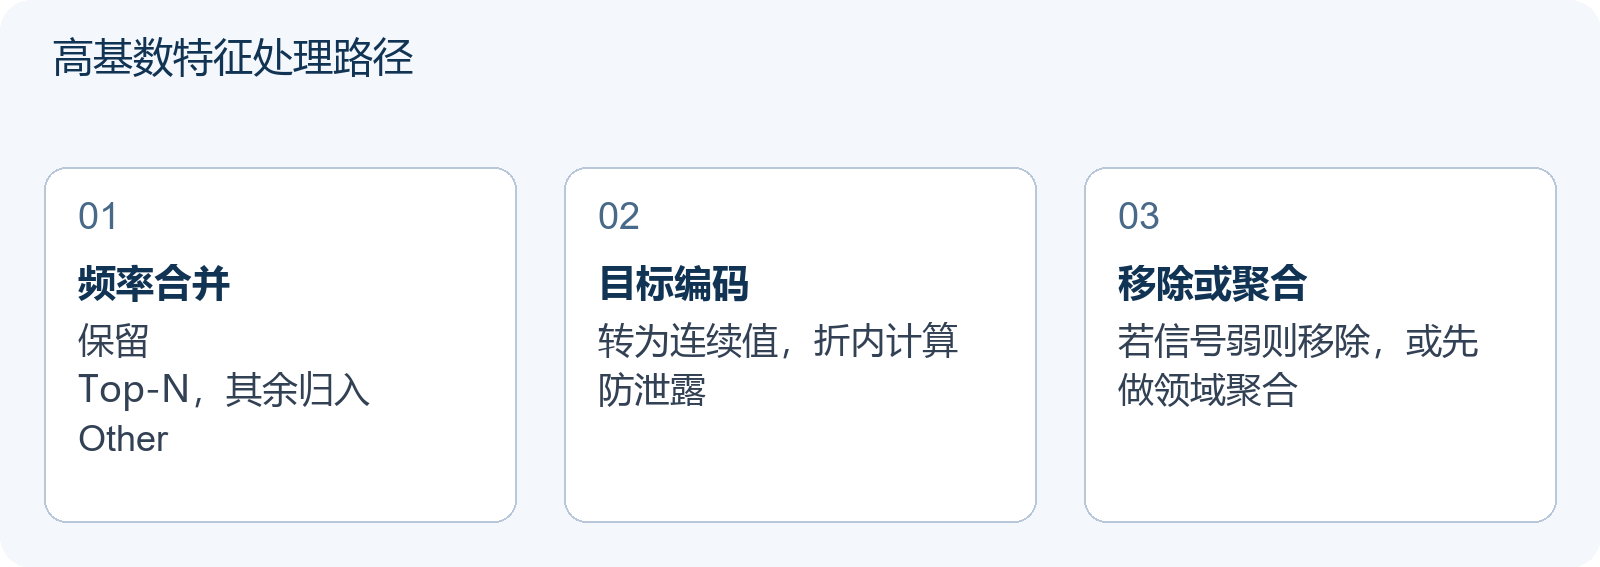
1. 频率合并
保留出现频率最高的 Top-N 个类别,其余全部合并为“Other”或“Rare”。例如保留 Top-200 再加一个 Other,总类别数为 201,小于默认 255,因此可以重新考虑原生支持。这个方法适合长尾分布明显的特征。教学提醒:合并后的 Other 内部异质性高,可能损失细粒度信号,必须用交叉验证确认收益。
2. 目标编码
把类别替换为该类别对应的目标均值或平滑均值,从而把高基数类别转为连续值。目标编码绕开了类别基数对 max_bins 的压力,但教学提醒:它容易导致数据泄露,统计量必须在每一折训练集内部独立计算,不能在全量数据上先算好再切分。相关切分纪律可参考站内《Kaggle分组交叉验证:同一用户出现在训练集和验证集怎么办》。
3. 低基数 one-hot 或移除
如果某个类别基数并不高,仍可把 one-hot 作为对照方案。如果基数极高且经过实验证明几乎没有稳定信号,直接移除或先做领域聚合,往往比强行编码更有效。判断新增特征是否真的有用,可参考站内《Kaggle特征消融实验:怎样判断新增特征是真的有用》。
实操诊断表:把基数、缺失率、新类别与验证分数一起看
编码方式不应只凭理论决定。建议按下面顺序做实验,并让每次实验只改变编码方式,保持模型参数、验证切分和评估指标一致。实验记录方法可参考站内《Kaggle实验管理:让特征、参数与验证结果能够一一对应》。
- 检查基数:对每个类别特征统计唯一值数量 K。若 K ≥ 255,标记为高基数候选,不能直接启用原生支持。
- 检查缺失率与新类别:统计训练集缺失比例,并在验证折中模拟测试集新类别比例。
- 基准实验 A:对 K < 255 的特征启用
categorical_features,记录交叉验证分数。 - 基准实验 B:对 K ≥ 255 的特征执行频率合并或目标编码,再记录交叉验证分数。
- 对比分析:如果合并后分数明显下降,说明信息损失较大,可尝试目标编码;如果目标编码不稳定,则回到分组交叉验证检查泄露或改用聚合特征。
结语:先看约束,再做实验
Kaggle 类别特征编码没有一刀切的答案。对使用 HistGradientBoosting 的表格赛,先把每个类别特征的基数与 max_bins 对比:小于 255 的低基数特征可以优先尝试原生支持;达到或超过 255 的高基数特征必须预处理或换路线。再结合缺失率、新类别比例和交叉验证分数决定最终编码。这样得到的结论才可复现,也才经得起测试集检验。
一般活动背景信息可参见scikit-learn 集成学习文档。
这是一份独立的备考指南,与 Kaggle 或其赛事主办方 无隶属、认可或赞助关系。
常见问题
HistGradientBoosting 的 max_bins 默认是多少?
默认值是 255。文档要求每个类别特征的基数必须严格小于 max_bins,并推荐尽量使用多的 bins(默认 255)。因此 K=255 也不满足直接启用原生支持的条件。
预测时遇到训练中没有的类别怎么办?
原生 categorical 支持会把未见类别当作缺失值处理。若训练时存在缺失值,缺失值会作为正式类别;若训练时没有缺失值,预测时的缺失值会走到样本数最多的子节点。评估时应单独统计新类别比例。
为什么 one-hot 编码有时不如原生支持?
scikit-learn 文档指出,one-hot 通常需要更多树深度才能达到等价分裂,且把无序类别当作连续有序值也不合适。原生 categorical 直接处理无序类别集合,在满足基数限制时通常更值得优先比较。